Qwen3.8-Flash 是通义千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。同时兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 是开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
一、Qwen3.8-Flash:AI大模型时代的新标杆
在人工智能技术飞速发展的今天,大语言模型已经成为推动各行各业数字化转型的核心引擎。从代码编写到文档分析,从智能客服到多模态理解,大模型的应用场景日益丰富,对模型性能、响应速度和成本控制的要求也在不断提升。在这样的背景下,阿里云通义千问团队推出了最新一代多模态大模型——Qwen3.8-Flash,旨在为开发者和企业提供一个兼具强大能力与极致效率的AI解决方案。
Qwen3.8-Flash作为通义千问系列的最新力作,不仅在模型能力上实现了全面升级,更在推理效率和部署灵活性方面做出了重大突破。它原生支持百万级上下文窗口,能够一次性处理超长文档、完整代码仓库和复杂多轮对话,这在当前大模型领域堪称领先。与此同时,该模型在编程辅助、智能体协作、图文理解等核心场景中表现尤为出色,无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。
更为重要的是,Qwen3.8-Flash在保持卓越性能的同时,提供了极具竞争力的推理成本,真正实现了"效果与效率兼得"的目标。对于正在寻找高性价比AI解决方案的开发者和企业而言,Qwen3.8-Flash无疑是一个值得深入关注的理想选择。
二、模型核心能力全面解析
2.1 多模态输入与输出
Qwen3.8-Flash在模态支持方面展现了强大的兼容性。在输入端,该模型支持图像(Image)、文本(Text)和视频(Video)三种模态的数据输入,这意味着用户可以在同一个对话中混合使用文字描述、图片上传和视频分析,模型能够综合理解多种信息源并给出统一的、高质量的回复。
在输出端,Qwen3.8-Flash目前以文本(Text)为主要输出形式。这种设计使得模型在生成回复时能够保持高度的精确性和可控性,特别适合于需要结构化输出、代码生成、文档撰写等对准确性要求较高的场景。
多模态输入能力的支持,使得Qwen3.8-Flash在以下场景中具有独特优势:
- 图文理解:用户上传产品图片、设计稿或截图,模型能够准确识别图片内容并结合文字描述进行分析和建议。
- 视频分析:对于长视频内容,模型能够理解视频中的关键帧、场景变化和语义信息,提供摘要、问答或深度分析。
- 文档处理:结合图像和文本输入,模型可以处理包含图表、公式和文字的复杂文档,实现全面的信息提取和理解。
2.2 百万级上下文窗口
Qwen3.8-Flash最令人瞩目的特性之一,是其原生支持的百万级上下文窗口。根据官方数据,该模型的上下文长度达到了1,000,000 tokens,最大输入长度为991,808 tokens,最大输出长度为131,072 tokens。在思考模式下,最大输入长度为983,616 tokens,最大输出长度同样为131,072 tokens,最大思维链长度更是达到了262,144 tokens。
这样的上下文容量意味着什么?让我们用几个具体的例子来说明:
- 超长文档处理:一本数十万字的小说、一份数百页的技术规范文档,或者一个完整的法律合同,都可以一次性输入模型进行理解和分析,无需分段处理。
- 完整代码仓库:一个中型项目的全部源代码可以一次性加载到上下文中,模型能够理解代码之间的依赖关系、调用链路和整体架构,从而提供更精准的代码建议和问题诊断。
- 复杂多轮对话:在长时间的对话交互中,模型能够记住之前所有的对话内容,保持上下文连贯性,不会出现"遗忘"之前讨论内容的情况。
- 长视频理解:结合视频输入能力,百万级上下文使得模型能够处理较长时间跨度的视频内容,进行全面的语义理解。
2.3 思考模式与思维链
Qwen3.8-Flash支持思考模式(Thinking Mode),在该模式下,模型会先生成一段思维链(Chain of Thought),然后再给出最终答案。最大思维链长度达到了262,144 tokens,这为模型提供了充足的"思考空间",使其能够在面对复杂问题时进行更深入、更全面的推理。
思考模式特别适用于以下场景:
- 复杂的数学推理和逻辑分析
- 多步骤的代码调试和优化
- 需要综合多方面信息进行决策的分析任务
- 长文档的深度理解和信息提取
2.4 Function Calling与结构化输出
Qwen3.8-Flash全面支持Function Calling(函数调用)能力,这意味着模型可以在对话过程中自动识别需要调用外部工具或API的场景,并生成相应的调用指令。这一能力使得模型能够与外部系统无缝集成,实现更加复杂的工作流自动化。
同时,模型支持结构化输出(Structured Output),可以按照用户指定的JSON Schema或其他格式规范生成输出内容。这对于需要精确数据格式的应用场景(如数据提取、表单填写、API响应生成等)尤为重要。
2.5 联网搜索能力
在部分部署区域(如华北2北京和新加坡),Qwen3.8-Flash支持联网搜索功能。这意味着模型可以在回答问题时实时检索互联网上的最新信息,确保回复内容的时效性和准确性。对于需要获取实时数据、最新新闻或动态信息的应用场景,联网搜索功能提供了极大的便利。
2.6 前缀续写与上下文缓存
前缀续写(Prefix Continuation)功能允许用户在已有的文本基础上继续生成内容,模型会基于前缀内容进行连贯的续写。这在创意写作、代码补全、文档扩展等场景中非常实用。
上下文缓存(Context Caching)功能则允许用户将常用的上下文内容缓存起来,在后续调用中直接复用,从而减少重复计算,降低延迟和成本。这对于需要反复使用相同系统提示词或背景知识的应用场景尤为有价值。
三、全球部署与区域覆盖
3.1 多区域部署策略
Qwen3.8-Flash在全球范围内进行了广泛部署,覆盖了多个重要区域,包括:
- 华北2(北京):面向中国大陆用户,提供完整的功能支持,包括联网搜索。
- 新加坡:部署范围为国际,面向东南亚及国际用户,同样支持联网搜索。
- 德国(法兰克福):部署范围为全球,面向欧洲用户。
- 日本(东京):部署范围为全球,面向亚太区域用户。
- 美国(弗吉尼亚):部署范围为全球,面向北美用户。
- 中国香港:部署范围为全球,面向港澳台及国际用户。
这种多区域部署策略确保了全球各地的用户都能以较低的延迟访问模型服务,同时也满足了不同地区的数据合规要求。
3.2 各区域功能差异
值得注意的是,不同部署区域在功能支持上存在细微差异。所有区域都支持的核心功能包括:多模态输入(Image、Text、Video)、文本输出、模型体验、Function Calling、结构化输出、前缀续写和上下文缓存。
主要差异在于联网搜索功能:华北2(北京)和新加坡区域支持联网搜索,而德国(法兰克福)、日本(东京)、美国(弗吉尼亚)和中国香港区域暂不支持联网搜索。此外,所有区域目前均不支持批量推理和模型调优功能。
3.3 兼容性优势
Qwen3.8-Flash在接口兼容性方面表现出色,同时兼容OpenAI和Anthropic两大主流接口协议。这意味着:
- 使用OpenAI SDK开发的现有应用可以几乎零成本地切换到Qwen3.8-Flash。
- 使用Anthropic接口规范的工具(如Claude Code)也可以直接对接。
- 开发者无需大幅修改现有代码即可享受Qwen3.8-Flash的强大能力。
这种高度的兼容性大大降低了迁移成本,使得开发者和企业能够快速将Qwen3.8-Flash集成到现有的技术栈中。
四、典型应用场景
4.1 编程辅助与代码智能
Qwen3.8-Flash在编程辅助领域展现了卓越的能力。凭借百万级上下文窗口,模型可以一次性理解整个代码仓库的结构和逻辑,提供以下服务:
- 代码生成:根据自然语言描述生成高质量的代码片段或完整模块。
- 代码审查:分析代码中的潜在问题、安全漏洞和性能瓶颈。
- 自动修复:识别代码中的bug并提供修复方案,甚至直接生成修复后的代码。
- 代码重构:建议更优的代码结构和设计模式,提升代码可维护性。
- 文档生成:自动为代码生成注释、API文档和使用说明。
结合Function Calling能力,Qwen3.8-Flash还可以与IDE插件、CI/CD管道和代码管理平台集成,实现开发工作流的全面智能化。
4.2 智能体协作
在AI Agent(智能体)领域,Qwen3.8-Flash同样表现出色。模型能够:
- 操作桌面应用:通过理解屏幕截图和执行指令,自动化操作各种桌面软件。
- 多步骤任务规划:将复杂任务分解为多个子步骤,逐步执行并动态调整策略。
- 工具调用编排:智能地选择和组合多个外部工具,完成复杂的工作流。
- 环境感知与适应:根据执行结果和反馈信息,动态调整后续行动方案。
这些能力使得基于Qwen3.8-Flash构建的智能体能够胜任各种复杂的自动化任务,从简单的数据录入到复杂的业务流程自动化。
4.3 图文理解与分析
多模态输入能力使得Qwen3.8-Flash在图文理解方面具有独特优势:
- 图表分析:上传数据图表,模型能够识别图表类型、提取数据点、分析趋势并给出洞察。
- 文档OCR与理解:处理扫描文档、PDF文件,提取文字内容并理解语义。
- 设计稿评审:分析UI设计稿,提供布局建议、一致性检查和用户体验评估。
- 产品图片分析:识别产品特征、比较不同产品、生成产品描述。
4.4 长视频理解
结合视频输入能力和百万级上下文窗口,Qwen3.8-Flash能够处理较长时间跨度的视频内容:
- 视频摘要:自动生成视频内容的结构化摘要。
- 关键事件检测:识别视频中的重要事件和转折点。
- 视频问答:针对视频内容回答用户的具体问题。
- 内容审核:检测视频中的不当内容或合规问题。
4.5 企业级应用
对于企业用户,Qwen3.8-Flash可以支撑多种企业级应用:
- 智能客服:结合知识库和联网搜索,提供准确、及时的客户服务。
- 文档智能处理:自动处理合同、报告、邮件等各类企业文档。
- 数据分析助手:理解数据报表,生成分析报告和决策建议。
- 培训与知识管理:基于企业内部文档构建智能问答系统。
五、价格与成本优势
5.1 定价详情
Qwen3.8-Flash在华北2(北京)区域的定价如下(以下为模型调用原价,不包含限时优惠等活动信息):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
5.2 成本优势分析
从定价来看,Qwen3.8-Flash展现了极强的成本竞争力:
输入成本极低:每百万tokens仅需0.8元,这意味着处理一篇约10万字的中文文档(大约相当于15万tokens),输入成本仅为0.12元左右。对于需要处理大量文档的企业应用而言,这一价格极具吸引力。
缓存机制大幅降低成本:当输入内容命中缓存时,价格从0.8元降至0.1元每百万tokens,降幅高达87.5%。对于需要反复使用相同系统提示词、背景知识或参考文档的应用场景,缓存机制能够显著降低总体成本。
输出价格合理:每百万tokens 2.7元的输出价格,考虑到模型支持最大131,072 tokens的输出长度,以及高质量的生成效果,这一价格在同级别模型中具有很强的竞争力。
显式缓存的灵活控制:显式缓存创建费用为1.25元每百万tokens,命中后仅为0.1元每百万tokens。开发者可以根据实际使用模式,灵活选择是否创建显式缓存,以优化成本结构。
5.3 成本优化建议
基于Qwen3.8-Flash的定价结构,以下是一些成本优化建议:
- 充分利用上下文缓存:对于固定的系统提示词和背景知识,使用上下文缓存功能可以大幅降低重复调用的成本。
- 合理使用显式缓存:对于频繁使用的参考文档或知识库内容,创建显式缓存可以在多次调用中持续享受低价。
- 优化输入长度:虽然模型支持百万级上下文,但在实际使用中,尽量精简输入内容,只保留与当前任务相关的信息,可以有效降低输入成本。
- 批量处理:将多个相关请求合并为一次调用,利用大上下文窗口的优势,减少总体的调用次数。
六、与主流模型的对比优势
6.1 上下文长度对比
在当前主流大模型中,Qwen3.8-Flash的100万tokens上下文长度处于领先水平。相比之下,许多竞品模型的上下文长度在128K到200K tokens之间,部分模型虽然声称支持更长上下文,但在实际使用中的有效利用率和性能表现往往不如Qwen3.8-Flash。
6.2 多模态能力对比
Qwen3.8-Flash同时支持图像、文本和视频三种模态的输入,这在同价位段的模型中较为少见。许多竞品模型要么仅支持文本输入,要么虽然支持多模态但在视频理解方面能力有限。
6.3 接口兼容性对比
同时兼容OpenAI和Anthropic两大接口协议,使得Qwen3.8-Flash在生态兼容性方面具有独特优势。开发者可以无缝对接Claude Code、Codex等主流开发者工具,无需进行大量的适配工作。
6.4 性价比对比
综合考量模型能力、上下文长度、多模态支持和定价,Qwen3.8-Flash在性价比方面具有明显优势。特别是在需要处理大量输入内容(如长文档分析、代码仓库理解)的场景中,其低输入价格和大上下文窗口的组合,使得总体使用成本远低于许多竞品。
七、开发者集成指南
7.1 快速接入
由于Qwen3.8-Flash兼容OpenAI接口协议,开发者可以使用现有的OpenAI SDK快速接入:
from openai import OpenAI

client = OpenAI(
    api_key="your-api-key",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {"role": "system", "content": "你是一个有帮助的助手。"},
        {"role": "user", "content": "请介绍一下你自己。"}
    ]
)
7.2 多模态调用
对于需要输入图像或视频的场景,可以在消息中包含多模态内容:
response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "请描述这张图片的内容。"},
                {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}
            ]
        }
    ]
)
7.3 Function Calling示例
利用Function Calling能力,可以让模型调用外部工具:
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "获取指定城市的天气信息",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "城市名称"}
                },
                "required": ["city"]
            }
        }
    }
]

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[{"role": "user", "content": "北京今天天气怎么样?"}],
    tools=tools
)
八、qwen3.8-flash千问大模型免费额度与相关活动参考
qwen3.8-flash 模型目前提供新用户免费 Token 额度,并已于近期完成降价调整;限时优惠活动信息需前往百炼控制台查看。详情可通过百炼平台了解:https://www.aliyun.com/product/bailian

免费额度
- 新用户赠送: 新用户登录即可领取超 1 亿免费 Tokens,有效期为 90 天。
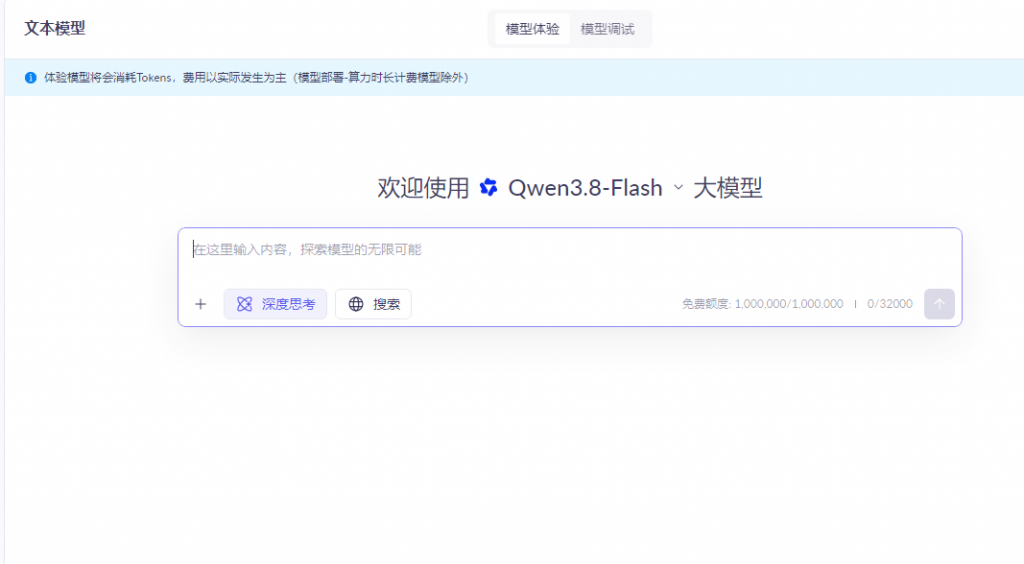
- 模型体验额度: 登录后每个模型免费赠送 100 万 tokens 推理额度。
价格与优惠
截至目前,qwen3.8-flash正在进行多项限时优惠活动:
1、Night Plan夜间错峰优惠:每日22:00至次日08:00,Token Plan用户调用qwen3.8-flash的Credits消耗享折扣,搭配上下文缓存可进一步降低使用成本,适合批量代码分析、长文档处理、多轮Agent调试等高消耗场景,权益自动生效无需手动操作;活动详情可参考:https://www.aliyun.com/benefit/client/nightplan

2、AI焕新季满减券:2026年9月30日前,完成实名认证并开通百炼平台的特邀用户,可领取满20减10、满99减15、满199减35三档满减券,可用于Token Plan订阅、Qoder套餐等产品抵扣,领取后14天内有效;详情可参考:https://www.aliyun.com/benefit/client/cross

3、OPC创新助力计划:面向独立开发者、自由职业者及“一人公司”,提供最低1000元、最高100万元Token补贴,采用“先用后返”模式,根据实际消费金额次月获得相应额度的满返优惠券,加速AI创新落地;详情可参考:https://opc.aliyun.com/products

4、Token Plan限时活动价:个人版三档套餐均有限时优惠,团队版标准坐席限时150元/席位/月,相比按量付费可节省30%以上成本,适合高频使用的开发者和团队。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan

九、总结
Qwen3.8-Flash作为阿里云通义千问系列的最新多模态大模型,在多个维度展现了卓越的实力:
- 强大的多模态理解能力:支持图像、文本和视频输入,能够处理各种复杂的信息理解任务。
- 百万级上下文窗口:100万tokens的上下文长度,使得处理超长文档、完整代码仓库和复杂对话成为可能。
- 出色的编程辅助能力:从代码生成到自动修复,从代码审查到重构建议,全面覆盖开发者的需求。
- 智能体协作支持:结合Function Calling和结构化输出,能够构建复杂的自动化工作流。
- 全球多区域部署:覆盖亚太、欧洲、北美等主要区域,确保全球用户的低延迟访问。
- 极具竞争力的定价:输入0.8元/百万tokens、输出2.7元/百万tokens的价格,配合缓存机制,为企业提供了极高的性价比。
- 优秀的生态兼容性:兼容OpenAI和Anthropic接口协议,可无缝接入现有开发工具链。
对于正在寻找高性能、低成本AI解决方案的开发者和企业而言,Qwen3.8-Flash无疑是一个值得优先考虑的选择。无论是构建智能客服系统、开发AI编程助手、搭建企业知识管理平台,还是探索多模态AI应用,Qwen3.8-Flash都能提供坚实的技术支撑和出色的使用体验。
👉友情提示:购买之前,别忘了先领阿里云免费赠送的折扣优惠券:
https://www.aliyun.com/minisite/goods 领了之后再买活动中的所有云产品,均可享受活动价格额外折扣,最高可减12500元。
在AI技术快速迭代的今天,选择一个既强大又经济的模型平台,对于企业的长期发展至关重要。Qwen3.8-Flash以其全面的能力、灵活的部署和优惠的价格,正在成为越来越多开发者和企业的首选。我们有理由相信,随着生态的不断完善和功能的持续增强,Qwen3.8-Flash将在AI应用的广阔天地中发挥越来越重要的作用,助力更多创新应用的诞生和落地。