阿里云通义千问 Qwen3.8 系列四款大模型(qwen3.8-max、qwen3.8-flash、qwen3.8-2.4t-a95b、qwen3.8-27b)的对比与选型参考:本文系统梳理了各模型的架构特点(如2.4万亿参数MoE旗舰模型、百万级上下文多模态模型、开源旗舰版本、27B原生视觉语言Dense模型)、模型能力(输入输出模态、Function Calling、联网搜索、结构化输出、上下文缓存等)、各地域部署情况(华北2北京、新加坡、德国法兰克福、美国弗吉尼亚、日本东京、中国香港)、上下文限制、按百万tokens计费的详细价格(含缓存命中价、显式缓存、Batch推理价等)、限流机制,并附带了免费额度(新用户超1亿免费Tokens)、Token Plan订阅套餐(39/139/499元三档)、Night Plan夜间4折优惠、模型限时折扣及Wan3.0视频模型7折优惠等最新活动信息。

一、qwen3.8-max:2.4万亿参数MoE架构旗舰模型深度解析
1.1 模型定位与核心特性
qwen3.8-max是通义千问系列中的顶级旗舰模型,采用2.4万亿参数的MoE(Mixture of Experts,混合专家)架构。这种稀疏激活架构的精妙之处在于:虽然模型总参数规模高达2.4万亿,但每次推理只激活其中的一部分专家网络,从而在保持顶级智能水平的同时,实现了相对可控的推理成本。
该模型在编程与办公场景能力上实现了显著提升,尤其适用于法律、金融、设计等对专业性和准确性要求极高的行业任务。更重要的是,qwen3.8-max具备原生视觉理解能力,支持超长文档与长视频的语义解析,并支持长程任务的自主规划与迭代——这意味着它不仅仅是一个"问答机器",而是能够像资深专家一样,理解复杂任务的完整脉络,自主拆解步骤、执行、验证并迭代优化,最终交付端到端的成果。
模型调用信息:
- 模型调用ID(
model参数取值):qwen3.8-max - 快照版本:
qwen3.8-max-0902(别名qwen3.8-max-2026-09-02)
1.2 全地域部署与模型能力矩阵
qwen3.8-max实现了全球化的广泛部署,覆盖华北2(北京)、新加坡(部署范围:国际)、德国法兰克福(部署范围:全球)、美国弗吉尼亚(部署范围:全球)、日本东京(部署范围:全球)以及中国香港(部署范围:全球)六大地域。
华北2(北京)地域能力:
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 支持 | 模型调优 | 不支持 |
值得注意的是,北京地域是唯一支持批量推理(Batch)的地域,这对于需要大规模离线处理任务的企业用户来说意义重大。
新加坡地域(部署范围:国际) 能力与北京基本一致,支持Image、Text、Video三模态输入,支持Function Calling、联网搜索、上下文缓存,但不支持批量推理与模型调优。
德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港四个全球部署地域的能力配置相同:均支持三模态输入、模型体验、Function Calling、结构化输出、前缀续写与上下文缓存,但联网搜索功能在这四个地域暂不支持,批量推理与模型调优同样不支持。这一点对于有实时信息检索需求的海外业务需要特别留意。
1.3 百万级上下文规格
qwen3.8-max的上下文规格堪称豪华:
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991808 | 最大输出长度 | 131072 |
| 最大输入长度(思考模式下) | 983616 | 最大输出长度(思考模式下) | 131072 |
| 上下文长度 | 1000000 | 最大思维链长度 | 262144 |
100万tokens的上下文长度意味着什么?粗略换算,这相当于可以一次性读入约750万字的内容——整套《红楼梦》加注释、一个中型企业的完整合同档案库、或者数小时的长视频语义信息,都可以在单次调用中完整处理。而131072的最大输出长度与262144的最大思维链长度,则保证了模型在深度思考模式下依然能够输出超长、连贯、结构完整的成果。需要说明的是,在不同的API输入参数组合下,模型支持的长度可能会有变化。
1.4 各地域价格明细
华北2(北京):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 36 | 每百万tokens |
| 输入(缓存命中) | 1.5 | 每百万tokens |
| 输入(Batch File) | 6 | 每百万tokens |
| 输出(Batch File) | 18 | 每百万tokens |
| 显式缓存创建 | 15 | 每百万tokens |
| 显式缓存命中 | 1 | 每百万tokens |
| 输入(Batch Chat) | 12 | 每百万tokens |
| 输出(Batch Chat) | 36 | 每百万tokens |
从价格体系可以看出几个关键的省钱要点:第一,缓存命中价格仅为原价的12.5%(1.5元对比12元),对于多轮对话或重复使用相同系统提示词的场景,上下文缓存能大幅降低成本;第二,Batch File批量推理输入输出均为原价的5折(6元/18元),适合非实时的批量处理任务;第三,显式缓存命中价格更低至1元每百万tokens,虽然创建成本为15元,但对于高频复用同一份长文档的场景(如法律条文库、产品手册问答),长期收益极为可观。
新加坡(部署范围:国际):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 14.988 | 每百万tokens |
| 输出 | 44.965 | 每百万tokens |
| 输入(缓存命中) | 1.874 | 每百万tokens |
| 显式缓存创建 | 18.736 | 每百万tokens |
| 显式缓存命中 | 1.274 | 每百万tokens |
新加坡地域价格约为北京地域的1.249倍,属于国际区域的标准溢价。
德国(法兰克福)、美国(弗吉尼亚)、日本(东京)三个全球部署地域的价格与北京一致:输入12元、输出36元、缓存命中1.5元、显式缓存创建15元、显式缓存命中1元(均为每百万tokens),这对全球化布局的企业是相当友好的定价策略。
1.5 限流机制解读
qwen3.8-max在华北2(北京)与新加坡地域采用动态限流机制:TPM(每分钟tokens数)限额根据用户在百炼平台的月消费档位动态调整,消费越多、限额越高;RPM(每分钟请求数)限额较高,正常使用不会触发限流,无需单独设置。这种"以用量换配额"的机制既保障了平台稳定性,也激励了重度用户。
而在德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港四个地域,主模型采用固定限额:RPM为30,000,TPM高达5,000,000,为高并发业务提供了充足的空间。
1.6 快照版本qwen3.8-max-0902:持续进化的智能巅峰
Qwen3.8-Max-0902(别名qwen3.8-max-2026-09-02)是qwen3.8-max的快照版本,它在多个维度实现了进一步突破:
- 编码深度再突破:可驾驭更复杂的工程级项目与长程自主开发任务,从单函数补全走向完整项目的自主构建;
- 协作智能体能力显著增强:在多工具调度与端到端交付中表现更从容,能够更好地与其他智能体、API工具协同工作;
- 视觉理解全面精进:图表推理、文档解析与多模态感知更敏锐准确;
- 完整能力延续:延续100万上下文、思考模式与完整工具生态,在更高智能水平上持续进化。
快照版本在北京地域的能力配置与主模型基本一致(但不支持批量推理),且在全球各部署地域均支持联网搜索——这是与主模型海外地域的一个差异化亮点。其上下文规格与主模型完全相同(100万上下文、131072最大输出、262144最大思维链)。
价格方面,快照版本与主模型保持一致:北京地域输入12元/输出36元/缓存命中1.5元/显式缓存创建15元/显式缓存命中1元;新加坡地域输入14.988元/输出44.965元/缓存命中1.874元/显式缓存创建18.736元/显式缓存命中1.274元;法兰克福、弗吉尼亚、东京与北京同价。
限流方面需注意:快照版本在海外全球地域(法兰克福、弗吉尼亚、东京、中国香港)的TPM限额为150,000(每分钟tokens),RPM为30,000,TPM明显低于主模型的5,000,000,海外高吞吐业务需提前规划。
二、qwen3.8-flash:百万上下文与极致性价比的速度之王
2.1 模型定位与核心特性
Qwen3.8-Flash是通义千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。
在编程辅助、智能体协作、图文理解等场景中,qwen3.8-flash表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。一个极具吸引力的特性是:它兼容OpenAI与Anthropic主流接口协议,可无缝接入Claude Code、Codex等开发者工具,这意味着已有基于其他厂商协议构建的应用可以低成本迁移,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash是开发者和企业在AI应用中兼顾效果与效率的理想选择。
模型调用ID(model参数取值):qwen3.8-flash
2.2 模型能力与地域部署
qwen3.8-flash同样部署于华北2(北京)、新加坡(国际)、德国法兰克福(全球)、日本东京(全球)、美国弗吉尼亚(全球)、中国香港(全球)六大地域。
北京与新加坡地域支持全部核心能力:Image、Text、Video三模态输入,模型体验、Function Calling、结构化输出、联网搜索、前缀续写、上下文缓存全面支持,批量推理与模型调优不支持。
法兰克福、东京、弗吉尼亚、中国香港四个全球地域与Max一致:联网搜索不支持,其余核心能力齐备。
2.3 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991808 | 最大输出长度 | 131072 |
| 最大输入长度(思考模式下) | 983616 | 最大输出长度(思考模式下) | 131072 |
| 上下文长度 | 1000000 | 最大思维链长度 | 262144 |
Flash版本与旗舰Max版本共享完全相同的百万级上下文规格,这在同价位段模型中极为罕见——通常轻量模型会缩减上下文窗口,而qwen3.8-flash做到了"减价不减配"。
2.4 价格:仅旗舰的十五分之一
华北2(北京):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
这是四款模型中价格最具冲击力的:输入价格仅为qwen3.8-max的1/15(0.8元对比12元),输出价格约为Max的1/13.3(2.7元对比36元)。缓存命中价格更是低至0.1元每百万tokens——几乎可以忽略不计。对于日均消耗数亿tokens的高并发应用(如客服机器人、内容生成流水线、代码辅助工具),选用Flash相比Max每月可节省数十万元的推理成本。
新加坡(部署范围:国际):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1.094 | 每百万tokens |
| 输出 | 3.427 | 每百万tokens |
| 输入(缓存命中) | 0.117 | 每百万tokens |
| 显式缓存创建 | 1.458 | 每百万tokens |
| 显式缓存命中 | 0.117 | 每百万tokens |
德国(法兰克福)、日本(东京)、美国(弗吉尼亚)三个全球地域均与北京同价:输入0.8元、输出2.7元、缓存命中0.1元、显式缓存创建1.25元、显式缓存命中0.1元(每百万tokens)。
2.5 限流机制
北京与新加坡地域采用动态限流机制,TPM限流值按百炼平台月消费额度分档,RPM限额较高、正常使用不会触发限流。法兰克福、东京、弗吉尼亚、中国香港四个全球地域则为固定限额:RPM 30,000、TPM 5,000,000,与Max主模型相同,充分满足高并发业务需求。
三、qwen3.8-2.4t-a95b:开源旗舰的顶级基准表现
3.1 模型定位与架构
Qwen3.8-2.4T-A95B是通义千问最新旗舰系列的开源版本,于2026年8月发布。它采用稀疏MoE架构,总参数2.4万亿,每步激活约950亿参数,配合混合注意力机制,支持100万Token上下文。
作为开源版本,它的意义在于让开发者和研究机构能够以开放的方式获取接近闭源旗舰水平的模型能力,可用于私有化部署研究、学术探索以及定制开发。
其核心基准测试成绩相当亮眼:
- GPQA Diamond 92.6:研究生水平科学问答基准,反映模型在物理、化学、生物等高难度领域的推理能力;
- PaperBench 93.0:论文复现能力基准,体现模型对复杂学术工程任务的处理水平;
- OSWorld 86.1:操作系统级智能体基准,衡量模型操作真实计算机环境的能力;
- BabyVision 82.0:视觉理解基准;
- CodeArena 全球第4:代码竞技场排名,直接证明其编程实力位居全球第一梯队。
3.2 服务与能力
qwen3.8-2.4t-a95b模型的推理服务供应商为阿里云百炼。
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
需要注意的是,该开源版本为纯文本模型(输入输出均为Text),不支持图像和视频输入——这是它与Max、Flash、27B的一个重要区别。如果您的业务涉及多模态处理,需要考虑其他三款模型。
3.3 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991808 | 最大输出长度 | 131072 |
| 上下文长度 | 1000000 | 最大输入长度(思考模式下) | 983616 |
| 最大输出长度(思考模式下) | 131072 | 最大思维链长度 | 131072 |
其最大思维链长度为131072,为Max/Flash(262144)的一半,但100万上下文与13万输出长度的规格依然属于顶级水平。
3.4 价格
华北2(北京):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 36 | 每百万tokens |
| 输入(缓存命中) | 1.5 | 每百万tokens |
| 显式缓存创建 | 15 | 每百万tokens |
| 显式缓存命中 | 1 | 每百万tokens |
新加坡(部署范围:国际):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 14.988 | 每百万tokens |
| 输出 | 44.965 | 每百万tokens |
| 输入(缓存命中) | 1.874 | 每百万tokens |
| 显式缓存创建 | 18.736 | 每百万tokens |
| 显式缓存命中 | 1.274 | 每百万tokens |
价格与闭源旗舰qwen3.8-max完全对齐,部署地域目前为北京与新加坡两地。限流同样采用动态机制:TPM限流值按百炼平台月消费额度分档,RPM限额较高、正常使用不会触发限流。
四、qwen3.8-27b:小而精的原生视觉语言Dense模型
4.1 模型定位
Qwen3.8系列27B是一款原生视觉语言Dense(稠密)模型。与MoE架构不同,Dense模型每次推理激活全部参数,具备部署简单、延迟稳定的特点。27B的参数规模使其可以在相对有限的算力资源上运行,是企业私有化部署和边缘场景的热门选择。
模型效果相较上一代3.6-27B重点提升了文本和视觉模态下的编程和办公场景能力,能更可靠地端到端完成复杂任务,输出值得信赖的成果。
4.2 服务与能力
qwen3.8-27b模型的推理服务供应商为阿里云百炼。
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
令人惊喜的是,这款27B小模型同样支持Image、Text、Video三模态输入,且功能矩阵与旗舰模型完全对齐(Function Calling、联网搜索、结构化输出、上下文缓存一应俱全)。
4.3 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991808 | 最大输出长度 | 131072 |
| 最大输入长度(思考模式下) | 983616 | 最大输出长度(思考模式下) | 131072 |
| 上下文长度 | 1000000 | 最大思维链长度 | 262144 |
27B版本同样拥有100万上下文与262144最大思维链长度,与Max/Flash规格一致。在不同API输入参数组合下,模型支持的长度可能会有变化。
4.4 价格:中量级任务的黄金选择
华北2(北京):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 3 | 每百万tokens |
| 输出 | 12 | 每百万tokens |
| 输入(缓存命中) | 0.6 | 每百万tokens |
| 显式缓存创建 | 3.75 | 每百万tokens |
| 显式缓存命中 | 0.3 | 每百万tokens |
新加坡(部署范围:国际):
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 3.646 | 每百万tokens |
| 输出 | 21.875 | 每百万tokens |
| 输入(缓存命中) | 0.729 | 每百万tokens |
| 显式缓存创建 | 4.557 | 每百万tokens |
| 显式缓存命中 | 0.365 | 每百万tokens |
27B的价格恰好位于Max(输入12元)与Flash(输入0.8元)之间,输入3元/输出12元的定价使其成为中等复杂度任务的高性价比选择。限流机制与前述模型一致:北京与新加坡地域采用动态限流,TPM按百炼平台月消费额度分档,RPM限额较高、正常使用不会触发。
五、四款模型横向对比与选型建议
5.1 核心参数对比总表
| 对比维度 | qwen3.8-max | qwen3.8-flash | qwen3.8-2.4t-a95b | qwen3.8-27b |
|---|---|---|---|---|
| 架构 | 2.4万亿参数MoE | 多模态高速模型 | 2.4万亿稀疏MoE(开源,激活约950亿) | 27B Dense |
| 输入模态 | Image/Text/Video | Image/Text/Video | Text | Image/Text/Video |
| 上下文长度 | 100万 | 100万 | 100万 | 100万 |
| 最大输出 | 131072 | 131072 | 131072 | 131072 |
| 最大思维链 | 262144 | 262144 | 131072 | 262144 |
| 输入价格(北京) | 12元/百万tokens | 0.8元/百万tokens | 12元/百万tokens | 3元/百万tokens |
| 输出价格(北京) | 36元/百万tokens | 2.7元/百万tokens | 36元/百万tokens | 12元/百万tokens |
| 缓存命中(北京) | 1.5元 | 0.1元 | 1.5元 | 0.6元 |
| 部署地域 | 6地域 | 6地域 | 北京+新加坡 | 北京+新加坡 |
| 批量推理 | 支持(仅北京主模型) | 不支持 | 不支持 | 不支持 |
| 开放程度 | 闭源 | 闭源 | 开源 | 开源系列 |
5.2 场景化选型建议
选择qwen3.8-max的场景:法律合同审查、金融研报分析、复杂工程设计、长视频语义解析、长程智能体自主规划等对智力上限要求最高的专业任务;需要Batch批量推理降本的大规模离线处理业务(仅北京地域支持);对端到端交付质量有严苛要求的企业级应用。
选择qwen3.8-flash的场景:高并发在线客服、内容生成流水线、代码自动修复、桌面应用操作智能体等对响应速度和成本敏感的业务;使用Claude Code、Codex等工具的开发者(OpenAI/Anthropic协议兼容);需要百万上下文处理超长文档但预算有限的项目。它是四款模型中性价比的绝对标杆。
选择qwen3.8-2.4t-a95b的场景:纯文本重度推理任务,如科研辅助(PaperBench 93.0)、操作系统级智能体(OSWorld 86.1)、高难度科学问答(GPQA Diamond 92.6);关注开源生态、希望跟进旗舰系列开放版本的研究团队与开发者;顶级代码任务(CodeArena全球第4)。
选择qwen3.8-27b的场景:中等复杂度的多模态任务,预算介于Max与Flash之间;办公场景自动化、图文理解、轻量编程辅助;希望以较低成本获得完整功能矩阵(三模态+联网搜索+Function Calling)的中小企业。
通用降本策略:无论选择哪款模型,都建议充分利用上下文缓存(命中价格低至原价的1/12甚至1/8)与显式缓存机制;北京地域用户可针对Max使用Batch File半价推理;有大量夜间批处理需求的用户可关注Night Plan夜间4折优惠(详见下文)。
六、免费额度与最新优惠活动全览
阿里云千问大模型目前提供新用户免费Tokens额度、Token Plan个人版订阅套餐以及部分模型的限时折扣优惠,善用这些活动可以显著降低使用门槛和成本。
6.1 免费额度
- 新用户赠送:新用户开通百炼平台即可领取超1亿免费Tokens,有效期为90天。这一额度足以支撑中小规模的完整POC验证——按qwen3.8-flash的输入价格计算,1亿tokens仅相当于80元的价值,但对于测试阶段完全免费。
- 模型体验额度:登录后每个模型免费赠送100万tokens推理额度,方便用户在多款模型之间横向实测对比。
- 额度管理:用户可在控制台开启"免费额度用完即停"功能,避免免费额度耗尽后产生意外扣费,这对个人开发者和预算敏感的初创团队非常实用。
详情可通过百炼平台了解:https://www.aliyun.com/product/bailian

6.2 Token Plan个人版订阅套餐
Token Plan个人版提供三档套餐,包含基础额度及夜间调用优惠等权益,支持月付、季付、年付:
- Lite版:39元/月,适合轻度使用的个人开发者与AI爱好者;
- Standard版:139元/月,面向日常有稳定调用需求的自由职业者与小型团队;
- Pro版:499元/月,为重度用户和专业开发者提供充足额度。
活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan

6.3 Night Plan夜间优惠
Qwen3.8-Max/Flash等模型在22:00后调用可享限时4折优惠。对于离线批处理、数据清洗、内容批量生成、模型评测等对实时性要求不高的任务,将调用调度到夜间时段可直接节省60%的成本。以qwen3.8-max为例,夜间输入成本可从12元降至约4.8元每百万tokens,与Batch折扣叠加考量后,夜间时段是旗舰模型最经济的使用时段。
6.4 模型限时折扣
- Qwen3.7-Plus和Qwen3.7-Flash的部分计费项(如输入/输出、Batch Chat)展示有限时8折或5折优惠;
- Qwen3.8-Max的Batch Chat计费项也展示有限时5折优惠——这意味着在北京地域使用Batch Chat调用Max,输入可低至6元、输出可低至18元每百万tokens,旗舰级智能以中端价格获取。
活动详情可参考:https://www.aliyun.com/benefit/client/nightplan

6.5 Wan3.0视频生成模型优惠
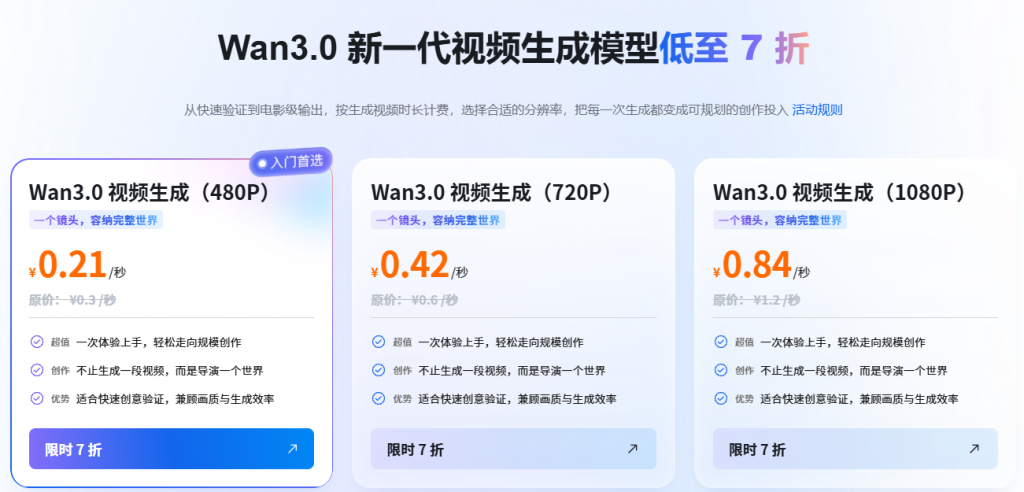
即日起至9月23日,阿里云百炼和千问AI平台的Wan3.0标准版API调用,Wan3.0视频生成模型享受后付费限时7折优惠,折后价格:
- 480P:0.21元/秒
- 720P:0.42元/秒
- 1080P:0.84元/秒
对于需要将文本理解(Qwen系列)与视频生成(Wan系列)结合的多模态内容创作管线,这是构建端到端AI视频工作流的好时机。
活动详情可参考:https://www.aliyun.com/benefit/scene/wan
总结
纵观Qwen3.8系列四款模型,阿里云构建了一个层次分明的大模型产品矩阵:qwen3.8-max以2.4万亿参数MoE架构和全面的多模态、长程规划能力占据智力制高点,是专业领域重型任务的首选;qwen3.8-flash以旗舰同款的百万上下文和十五分之一的价格成为高并发应用的性价比之王;qwen3.8-2.4t-a95b作为开源旗舰,以GPQA Diamond 92.6、CodeArena全球第4的硬核基准成绩服务科研与顶级代码场景;qwen3.8-27b则以3元/12元的中间定价和完整的三模态能力矩阵,为中小企业提供了均衡可靠的选择。
在实际决策中,建议您遵循以下路径:首先利用新用户超1亿免费Tokens和每模型100万tokens的体验额度进行实测对比;其次根据任务的模态需求(是否需要图像/视频输入)、智力要求(专业推理还是常规任务)和调用规模(高并发还是低频重型)缩小选择范围;最后综合运用上下文缓存、显式缓存、Batch批量推理、Night Plan夜间4折等降本手段,将推理成本压至最优。
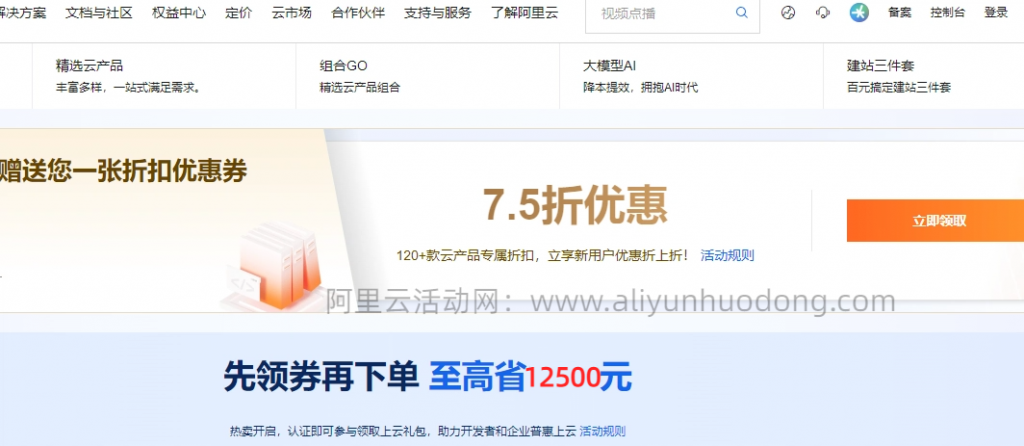
👉友情提示:购买之前,别忘了先领阿里云免费赠送的折扣优惠券:
https://www.aliyun.com/minisite/goods 领了之后再买活动中的所有云产品,均可享受活动价格额外折扣,最高可减12500元。
大模型选型没有标准答案,只有最适合业务场景的答案。希望本文的详细对比能帮助您在Qwen3.8系列中找到那把最趁手的"钥匙",开启高效的AI应用之旅。更多实时活动与优惠信息,请访问千问大模型在线体验控制台:https://www.aliyun.com/exp/llm查询。