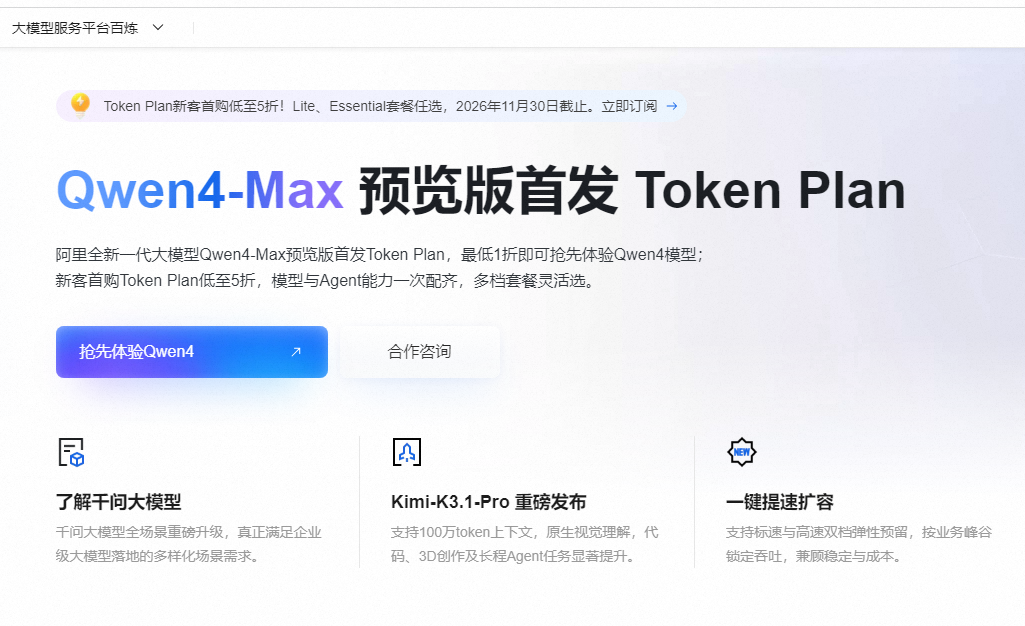
Qwen4-Max预览版已于11月11日发布,编程与智能体能力明显升级,但能不能接、敢不敢用、怎么买最省,需要先看清三点。一是版本状态:预览期至11月25日24:00,期内模型行为不变、结果可复现,到期后模型ID下线、正式版换用新名,因此只宜用于能力评估与场景验证,不可接入生产。二是调用通道:预览版仅支持Token Plan订阅,不支持按量付费,须使用专用API Key与专属Base URL。三是成本:个人版Lite档39元/月起,新客首购5折叠加预览期2折,最低19.5元/月即可试跑一个月。它擅长复杂编程、长链路智能体与图像视频原生输入,配合1M上下文,适合用真实任务做两周评估。
一、先搞清楚:Qwen4-Max到底是个什么状态?
在谈价格和场景之前,必须先把版本状态说清楚——这是很多开发者最容易踩的坑。
目前开放的Qwen4-Max是预览版,模型ID是qwen4-max-preview,不是正式稳定版。官方给的预览窗口期非常明确:2026年11月11日10:00到11月25日24:00,一共14天半,约350小时。这段时间内模型行为不会变更,你得到的测试结果是可复现的;但窗口期一结束,这个模型ID就会下线,正式版会用新的模型名发布。
这意味着什么?三点直接结论:
- 现在可以放心测试,不用担心今天测的结果明天因为静默升级就变了;
- 绝对不能直接把预览版接进生产环境,否则11月25日之后你的服务会直接挂掉;
- 这是一个黄金评估窗口,你有两周时间用自己的真实任务测试它,为正式版上线做准备。
另外一个重要信息:预览版仅支持Token Plan订阅调用,不支持按量付费。也就是说,你之前百炼账号里的按量付费余额、资源包、节省计划,都不能用来调这个模型,必须单独订阅Token Plan才行。接入的时候还要注意,必须使用Token Plan专属的API Key(sk-sp-开头)和专属Base URL(https://token-plan.cn-beijing.maas.aliyuncs.com),用百炼通用API Key是调不通的,也抵扣不了套餐额度。
在千问家族里,Qwen4-Max是毫无疑问的旗舰档。Qwen4系列一共规划了四个档位:
- Qwen4-Max:性能上限,旗舰档,主打复杂推理和编程;
- Qwen4-Plus:均衡档,性能速度成本三者平衡;
- Qwen4-Flash:高速低成本档,适合高频调用;
- Qwen4-27B:中等规模,面向本地部署。
记住一个原则:旗舰模型只用来干旗舰该干的活。用Max跑简单问答、文案生成,就像用跑车拉货,既浪费钱又体现不出优势。
二、Qwen4-Max到底强在哪?四个核心能力拆解
官方给Qwen4-Max定了四个升级方向:知识理解、世界感知、编程、智能体。其中编程和智能体是这次的重头戏,也是它和上一代Qwen3-Max最大的区别。
1. 编程能力:这是真能干活的编程模型
编程能力是Qwen4-Max这次最硬核的升级。之前很多大模型也说自己会编程,但大多停留在"写个排序算法""写个简单网页demo"的水平,真到了多文件项目、仓库级重构、debug复杂bug的时候就拉胯了。Qwen4-Max这次瞄准的是真实开发场景:
- 完整大型项目代码生成,不是单文件玩具;
- 仓库级代码审计、架构重构、漏洞排查;
- 前端网页、3D建模脚本、软件自动化代码直接产出;
- 自动调试报错、补全单元测试、生成项目文档。
最有说服力的证据不是跑分,而是Qoder的盲测:Qoder之前有个匿名测试模型叫Qoduck,用户不知道它是什么模型,实打实用了四天,每天模型都在更新。11月11日Qoder官方揭榜,Qoduck就是Qwen4-Max-Preview,而且已经全量上线Qoder所有套餐,包括Teams和Enterprise版。开发者用真金白银的订阅投了四天票,最后揭榜是Qwen4-Max,这个比任何官方跑分都靠谱。
有海外开发者实测,一次生成消耗69k Tokens,用Java和Three.js直接写出了一段完整的3D渲染,效果达到可交付水平。这对于做前端、做游戏、做可视化的开发者来说,吸引力是巨大的。
2. 智能体能力:从"会调用工具"到"能把事做完"
智能体(Agent)是今年大模型圈最热的方向,但很多模型的Agent能力其实就是简单的Function Calling,遇到长任务很容易断链、死循环、跑偏。Qwen4-Max这次的Agent升级是质的变化:它能围绕复杂目标自己拆分步骤,自主决定什么时候调用搜索、什么时候写代码、什么时候处理文件,整个长周期任务不需要人一步步干预,不容易卡壳。
上一代Qwen3-Max-Thinking的Agent能力还停留在"在对话里选工具用"的阶段,Qwen4-Max直接把动作空间扩展到了"操作图形界面软件"——也就是说,它不只是调用API,还能像人一样操作专业软件完成工作。官方说能支持专业办公和专业软件操作,这个想象空间就很大了。
但这里也给开发者提个醒:测试这个模型的时候,别再用"1+1等于几""写一首诗"这种简单问题测了,你测不出来区别。一定要用你手上真实的、完整的、需要多步骤完成的任务链路去测,看它能不能从头到尾把事做完,这才是Qwen4-Max的正确打开方式。
3. 多模态能力:旗舰模型原生支持图文视频输入
之前用千问旗舰模型处理图文混合任务,你需要同时调文本模型和视觉模型,自己拼接结果。Qwen4-Max直接把视觉理解做进了旗舰模型里,原生支持文本、图像、视频三种输入,输出文本。
这意味着什么?你可以直接给它发页面截图让它找bug,发带图表的研报让它提取数据,发图纸让它解读,发长视频让它总结内容——不用再拆分给不同模型处理了。特别是做UI开发、做数据分析、做内容审核的场景,这个原生多模态能力能省掉大量拼接工作。
4. 工程友好能力:这才是能落地的模型
对开发者来说,比跑分更重要的是工程接入好不好用。Qwen4-Max这方面做得非常到位:
- 1M上下文窗口:正式版支持100万Token上下文,能一次性读入几十万字的合同、整本书、完整代码库,不用再做切片;
- 结构化输出:同时支持JSON Object和JSON Schema,后者可以预先约束字段结构,模型保证输出符合Schema,直接接业务系统不用写一堆后处理校验代码;
- API兼容:完美兼容OpenAI Chat Completions、OpenAI Responses、Anthropic Messages三种主流协议,还有自家DashScope协议。也就是说,你之前用Claude、用GPT写的代码,换个Base URL和API Key就能直接切过来,迁移成本极低;
- 显式缓存:支持复用系统提示词、工具说明等公共前缀,TTL支持5分钟和1小时,能大幅降低重复输入的成本;
- 思维链加密:返回思维链摘要和密文,多轮对话回传密文就能恢复历史思考,不用担心把思考过程暴露给用户,也不用重复思考浪费Token。
这里有个天大的坑必须提醒你:从Qwen4-Max开始,max_tokens限制的是思考过程+最终回答的总Token量,之前的模型只限制回答长度。如果你把旧代码里的max_tokens=2048直接搬过来,高推理档位下思考过程就可能把额度吃光,回答被截断还不报错,你debug半天都找不到原因。正确做法是把输出上限调大,给思考留足空间,不需要深度思考的简单任务把reasoning_effort调到low或medium,既快又省。
三、哪些场景该用Qwen4-Max?哪些场景别浪费钱?
我按开发者的真实工作场景给你划清楚边界,别再拿旗舰模型干杂活。
强烈推荐用Qwen4-Max的场景:
- 复杂编程任务:多文件全栈项目开发、仓库级代码重构、深层bug定位、前端交互页面实现、3D建模脚本、自动化测试生成——这是它的强项,闭着眼睛用;
- 长链路Agent开发:需要多轮工具调用、自主拆分任务、跨工具协同的智能体,比如科研助手、财务分析机器人、办公自动化Agent,它的长任务不容易断链;
- 长文档+多模态混合分析:整份合同审查、代码库审计、图文混排研报解读、视频内容分析,1M上下文+原生多模态能一次性处理,不用切片拼接;
- 需要严格结构化输出的业务链路:要把模型输出直接存数据库、直接给下游系统用,JSON Schema支持能大幅降低失败率;
- 新模型预研和技术储备:现在两周预览期成本极低,正好摸清楚它的能力边界,等正式版上线直接就能接上。
别用Qwen4-Max,用低档位模型更划算的场景:
- 高并发简单问答:客服回复、批量文本分类、简单信息抽取,用Qwen4-Flash或Qwen4-Plus,成本能差一个数量级;
- 生产环境稳定业务:等正式版出来再说,现在预览版11月25日就下线,别给自己找运维麻烦;
- 本地部署、数据不出域需求:Qwen4-Max是闭源云服务,等Qwen4-27B正式发布后用那个,或者继续用Qwen3.8-27B;
- 极致数学推理:现在Qwen4-Max的数学跑分还没公布,极致数学和科学推理场景继续用Qwen3-Max-Thinking,它的HLE 58.3分、IMO 91.5分是已经验证过的;
- 明确要按量付费、不想订阅的:预览版只支持Token Plan,不想订阅就等正式版按量付费通道开放。
简单总结:活儿越难、链路越长、步骤越多,Qwen4-Max的优势越明显;活儿越简单、量越大、对延迟越敏感,越应该用低档模型。把好钢用在刀刃上,才是成本最优解。
四、活动价格全解析:怎么买最划算?我给你算笔细账
很多开发者看价格只看"几折",最后算下来反而花了冤枉钱。我把Token Plan的价格体系拆解得明明白白,告诉你每一档值不值,怎么组合最省钱。
首先要明确两个最基本的概念,别搞混了:
- 订阅费:你每月掏的月费,买的是每月固定的Credits额度,这是"门票钱";
- 模型折扣:调用Qwen4-Max时消耗Credits的倍率,预览期2折、新客叠加最低1折,这是"单次消费折扣"。 两者是相乘关系,不是相加关系。订阅费5折+模型2折,才是最终的1折,不是总共7折。
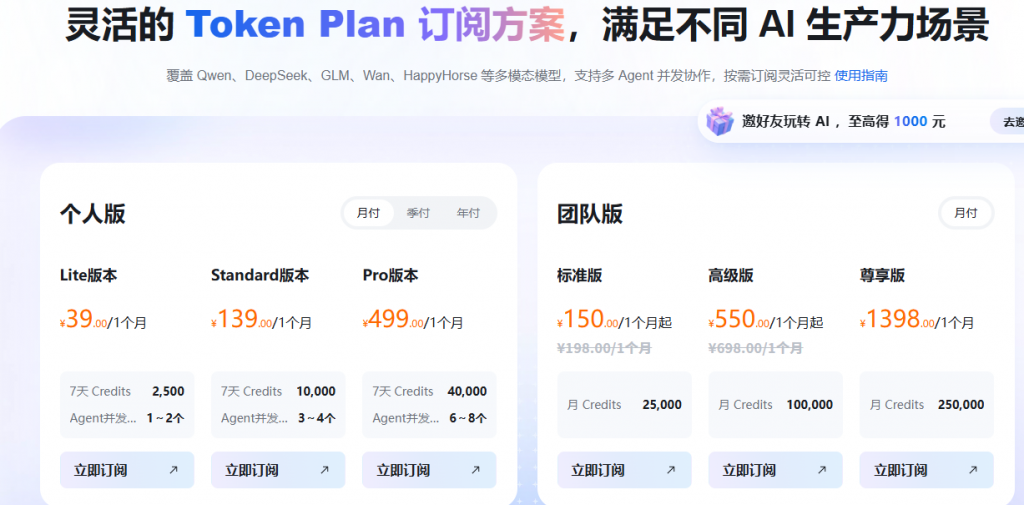
个人版四档详细对比
| 档位 | 月费 | 双11新客首购价 | 每月Credits | 单位Credits成本 | 并发Agent | 适合人群 |
|---|---|---|---|---|---|---|
| Lite | 39元 | 19.5元 | 20,000 | 日常0.00195元,新客0.000975元 | 1-2个 | 个人开发者尝鲜、轻度使用 |
| Essential | 79元 | 39.5元 | 45,000 | 约0.00176元 | 2-3个 | 日常开发高频使用 |
| Standard | 139元 | 69.5元 | 80,000 | 约0.00174元 | 3-4个 | 重度开发者,附赠Harness权益 |
| Pro | 312元 | 156元 | 200,000 | 日常0.00156元 | 6-8个 | 专业开发者、小团队 |
11月9日这次调整非常良心:Lite、Essential、Standard三档价格没涨,额度直接涨了74%-78%;Pro档直接从499元降到312元,额度还加了2万,单位成本直接降了43.7%。再叠加双11新客首购5折,Lite档19.5元就能用一个月,这价格真的就是一杯奶茶钱。
团队版价格我也给你列出来,适合5人以上团队:
- 标准座席:150元/月(原价198),25000 Credits/席,适合团队普通成员;
- 高级座席:550元/月(原价698),100000 Credits/席,适合核心开发;
- 尊享座席:1398元/月,250000 Credits/席,适合重度使用场景。
团队版看起来单位Credits成本比个人版高,但它有个个人版比不了的优势:承诺不使用你的对话数据训练模型,而且有多租户隔离、席位管理、用量分析等企业级功能。做商业项目、处理客户数据、有合规要求的团队,千万别省这点钱,直接上团队版。更多阿里云大模型详情可参考:https://www.aliyun.com/product/bailian
我的推荐购买路径:零风险低成本试错
我给所有开发者的建议都是一样的,按这个顺序来,绝对不花冤枉钱:
第一步:先领免费额度,一分钱不花先测效果新用户开通百炼直接送超7000万Tokens,70多款主流模型每款100万,Qwen4-Max也有100万免费额度(正式版上线后)。先用这个额度跑你自己的真实任务,测个三五天,看看效果到底满不满意、大概一天消耗多少。这一步零成本,别上来就买套餐。 免费额度领取地址:https://free.aliyun.com/product/ai

记住一定要开"免费额度用完即停",不然额度用完了自动转按量扣费,你都不知道。
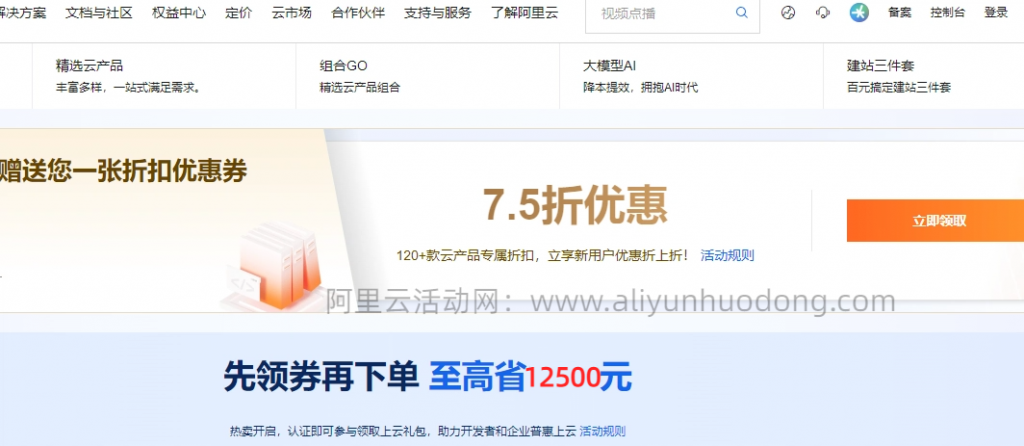
第二步:领通用优惠券,折上再减买任何东西之前先领券,这是基本操作。阿里云官方权益中心的优惠券,所有云产品都能用,不领白不领。 领券详情:https://www.aliyun.com/minisite/goods 领了之后再买活动中的所有云产品,均可享受活动价格额外折扣,最高可减12500元。
第三步:买19.5元的Lite档首月,实测真实消耗确认Qwen4-Max有用、适合你的场景,先买一个月19.5元的Lite档,别一上来就买Pro。用这一个月时间跑你的真实任务,每天记一下Credits消耗,算出来一个月稳定用多少,再决定升不升档。这样就算试错了,也就损失一杯奶茶钱。 Token Plan活动页:https://www.aliyun.com/benefit/scene/tokenplan
第四步:用夜间折扣跑批量任务,额度最大化千问系列有夜间折扣,每晚22点到第二天早上8点调用更便宜。代码重构、文档批量解析、模型对比测试这种不急的任务,都设成定时任务夜里跑,同样的额度能多用一倍多的量。
第五步:别买加油包,不够用直接升档个人版加油包100块钱20000 Credits,算下来单位成本是Pro档的3.2倍,非常不划算。如果你连续一两周都把额度跑光了,直接升级到下一档,长期来看比买加油包便宜得多。加油包只适合某个月偶尔超量的应急场景。
五、接入避坑指南:这些问题我帮你踩过了
最后给大家列几个接入时最容易踩的坑,我整理好了,你们别再踩一遍:
- 模型ID别写错:预览版是
qwen4-max-preview,别写成qwen4-max,后者现在还没上线,调不通的;两个IDqwen4-max-preview和qwen4.0-max-preview都能用,但建议写在配置文件里别硬编码,11月25日之后要换成正式版ID。 max_tokens一定要调大:至少设到32768以上,不然思考过程就把额度占满了,回答出不来还不报错。- 必须用Token Plan专属凭证:
sk-sp-开头的API Key,专属Base URL,用百炼通用Key是调不通预览版的。 - 历史思考要完整回传:多轮对话的时候,之前返回的
reasoning_content要原样传回去,别拼到content里,不然模型记不住之前想了什么。 - 记得配置用量告警:Credits用完了服务会暂停,设个日度和月度告警,别用到一半突然停了影响工作。
- 个人版和团队版数据政策不一样:个人版数据会用于模型改进,商业机密和客户数据一定用团队版,别省这点钱。
最后总结
Qwen4-Max预览版的发布,标志着国产大模型正式从"拼跑分"进入"拼任务完成率"的阶段。它的编程和智能体能力确实达到了新的高度,对于需要处理复杂任务的开发者来说,现在19.5元就能体验一个月,试错成本几乎可以忽略不计。
但我也要给大家泼点冷水:现在它还是预览版,参数、跑分、正式价格都没完全公布,别听网上那些"全面超越GPT""吊打Claude"的瞎吹。最好的方式就是自己花一杯奶茶钱,拿你手上最难的真实任务测两周,记录下成功率、消耗、输出质量,形成你自己的判断——模型好不好用,从来不是跑分说了算,而是它能不能帮你把活干完。