2026 年 11 月 11 日,阿里全新一代大模型 Qwen4-Max 预览版发布,首发渠道为千问 AI 平台的 Token Plan 订阅服务。Qwen4 模型拥有更强的世界知识和感知能力,并在编程与 Agentic(智能体任务执行)这两项最关键的能力上再度升级,能更好地完成复杂编程、专业办公、前端设计、专业软件操作等真实任务。开发者提前内测的成果显示,Qwen4 在 3D 建模、网页设计、交互等方面表现出较高完成度。本次开放的是旗舰模型 Qwen4-Max 的预览版本,模型标识为 qwen4-max-preview,别名 qwen4.0-max-preview,两个 ID 均可调用。价格方面,Token Plan 用户可限时享受 2 折,新用户在此基础上再享折上 5 折,叠加后最低为原价的 1 折。千问办公、Qoder、千问 APP、QwenStudio 等产品同步接入,可第一时间体验。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
需要先行说明的是,Qwen4-Max 当前处于预览阶段,官方尚未公布参数规模、上下文窗口、基准跑分、与上一代的量化对比、开源计划与 API 定价。本文严格区分四类信息源的可靠性等级:官方明确表述、平台文档记录、第三方评测数据、社区与自媒体线索,并对未披露项一律标注"尚未公布",不以推测数值填充。这样做的目的在于避免把传闻当作参数,也避免把定性描述包装成量化结论。
一、信息口径与核实边界
1.1 已确认事项清单
以下事项在 2026 年 11 月 11 日时点可确认:
- 模型标识为
qwen4-max-preview,别名qwen4.0-max-preview; - 上线时间为 2026 年 11 月 11 日,预览窗口期至 11 月 25 日 24:00(UTC+8);
- 首发渠道为 Token Plan,同步接入千问办公、Qoder、千问 APP、QwenStudio;
- 支持文本、图像、视频输入,文本输出;
- 属于推理模型,支持深度思考模式;
- 支持 Function Calling 与联网搜索、网页抓取、代码解释器等内置工具;
- 支持 JSON Object 与 JSON Schema 两种结构化输出;
- 兼容 OpenAI 与 Anthropic API 协议;
- 升级方向为知识理解、世界感知、编程能力、智能体能力四个方面。
1.2 尚未公布事项清单
以下事项官方均未披露,任何具体数值都属于推测,不应作为决策依据:
- 参数规模(是否超过 Qwen3.8-Max 的 2.4 万亿 MoE);
- 上下文窗口长度(网络流传的"百万上下文"在阿里官方页面并无记载);
- 预训练数据量;
- 基准测试项目与评分结果;
- 与 Qwen3-Max、Qwen3-Max-Thinking 的量化对比;
- 是否延续混合专家(MoE)架构及激活参数规模;
- 是否开源及采用何种许可证;
- 正式版发布时间与 API 按量定价。
阿里方面仅表示该模型在多项实际任务测试中取得进展,未披露具体测试项目与评分结果。
二、Qwen4-Max 的定位与版本状态
2.1 在千问模型矩阵中的位置
Qwen4-Max 是阿里云千问(Qwen)系列第四代的旗舰大模型,在模型矩阵中处于性能上限位置。按 2026 年 11 月上旬第三方媒体对 Qwen4 家族的梳理,该系列至少规划四款主力模型:
| 型号 | 定位 | 目标场景 |
|---|---|---|
| Qwen4-Max | 性能上限、旗舰档 | 复杂任务与专业场景 |
| Qwen4-Plus | 均衡档 | 性能、速度与成本平衡 |
| Qwen4-Flash | 低成本高速档 | 高频调用、成本敏感场景 |
| Qwen4-27B | 中等规模档 | 本地部署、数据不出域 |
阿里云百炼的模型选择文档中,qwen4-max-preview 被归类的适用方向为"复杂推理与编程(Token Plan)",并在模型选型建议中被列为"效果优先"选项,这与其旗舰定位一致。详情可通过阿里云百炼平台了解:https://www.aliyun.com/product/bailian
2.2 预览版属性的准确理解
按千问 AI 平台对模型版本的定义,预览版主要用于新能力验证和收集使用反馈,后续可能持续更新,与面向生产环境的稳定商用版本有所区别。
阿里云百炼 Token Plan 个人版文档给出了明确的预览窗口期:2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00(UTC+8),期间不做变更,预览结束后下线。该窗口期合计 14 天 14 小时,约 350 小时。
由此可以得出四条实际结论:
- 当前的 Qwen4-Max 是限时可体验的预览版本,不是长期稳定的商用 API;
- 预览期内模型行为不做变更,这为开发者提供了一致的测试基准,是进行能力评估的有效窗口;
- 预览结束后该模型标识会下线,正式版将以新的模型名发布,接入方需要预留改配置的工作量;
- "期间不做变更"意味着预览期内不会出现静默升级,测试结果具备可复现性,这一点对严肃的能力评估尤为重要。
对生产环境而言,这意味着预览版适合用于能力评估、场景验证与提前适配,而不适合直接承载不可中断的线上业务。
2.3 发布路径的特殊性
Qwen4 的发布路径与行业常见做法不同。传统路径通常是"开发布会 → 开放 API → 逐步接入应用",而 Qwen4 采用的是"预览版先进入计费平台与多类应用 → 收集真实调用反馈 → 再发正式版"。
这一节奏变化释放出两个信号:
- 模型能力先进入真实调用场景,通过实际负载与用户反馈驱动后续迭代,而非先在评测集上完成优化再对外;
- 开发者接触新旗舰模型的时间点明显提前,代价是需要接受预览版的不确定性,同时自己踩到的问题与提交的反馈会影响下一个版本。
从产业视角看,这种"先试后发"的做法把模型竞争从单点能力展示,推向"模型发布—Token 计费—应用放量—算力供给"的连续过程。对使用者的直接影响是:评估窗口前移,适配工作也需要前移。
三、技术规格:qwen4-max-preview
本章内容依据阿里云百炼模型文档记录整理,属二级信息源,可作为技术接入依据。
3.1 模态与推理能力
| 规格项 | 记录内容 |
|---|---|
| 模型定位 | 通义千问新一代旗舰多模态模型 |
| 上线时间 | 2026 年 11 月 11 日(预览) |
| 输入模态 | 文本、图像、视频 |
| 输出模态 | 文本 |
| 推理属性 | 推理模型,支持深度思考模式 |
| 模型 ID | qwen4-max-preview |
| 别名 | qwen4.0-max-preview(两个 ID 均可调用) |
该模型融合文本生成、图片与视频理解及深度思考能力,适用于编程开发、办公、前端设计与复杂智能体任务。
需要指出一处口径差异:阿里云百炼模型清单中对 qwen4-max-preview 标注的能力标签为"模型推理、文本生成、视觉理解",未单列视频;而模型文档记录其输入模态包含视频。两处均属官方来源,处理原则是以更细粒度的模型文档为准,即确认支持视频输入,同时留意视频输入在预览期可能存在时长、分辨率或帧率上的限制,具体以调用时的接口返回为准。
3.2 工具调用能力
支持 Function Calling,并内置以下工具能力:
| 工具名称 | 能力 |
|---|---|
web_search | 联网搜索 |
web_extractor | 网页抓取 |
code_interpreter | 代码解释器 |
在 Token Plan 体系下,模型内置工具通过 Responses API 调用模型时自动触发,按 Credits 统一抵扣,无需单独接入。需要留意的是,在按量付费体系中,部分内置工具会在模型 Token 费用之外按调用次数另行收费;由于 qwen4-max-preview 当前仅支持 Token Plan 调用,这一差异暂不适用,但正式版上线后需重新核对计费规则。
3.3 结构化输出
同时支持 JSON Object 与 JSON Schema 两种结构化输出格式。这一规格对工程接入有实际意义:
- JSON Object 仅约束输出为合法 JSON,字段结构由提示词控制,适合结构相对灵活的场景;
- JSON Schema 允许预先声明字段名、类型与必填项,由模型侧保证输出符合 Schema,适合下游系统直接解析、不容许字段缺失或类型漂移的生产链路。
相较仅支持 JSON Object 的模型,同时支持 JSON Schema 可以显著减少后置校验与重试逻辑,降低智能体链路的失败率。
3.4 API 兼容性
兼容 OpenAI 与 Anthropic API 协议。这意味着现有基于两套协议构建的工具与代码可以较低成本切换,包括 Claude Code、Cursor、Qwen Code、Qoder、Qoder CN、Cline、OpenClaw、Cherry Studio、Chatbox 等支持自定义 Base URL 与 API Key 的工具。
3.5 接入与计费限制
| 限制项 | 具体内容 | 工程影响 |
|---|---|---|
| 计费方式 | 仅支持 Token Plan 调用,不支持按量付费或其他计费方式 | 未订阅 Token Plan 的账号无法调用;已有按量付费集成需另建链路 |
| 服务周期 | 预览期 2026 年 11 月 11 日 10:00—11 月 25 日 24:00(UTC+8),结束后下线 | 需预留模型标识切换的改造工作量 |
| 模型标识 | qwen4-max-preview / qwen4.0-max-preview | 建议在配置中将模型名参数化,避免硬编码 |
"仅支持 Token Plan"这一条对既有架构的影响需要单独评估:Token Plan 与按量付费是两套独立体系,额度互不通用。若业务系统原本通过按量付费调用 qwen3-max,接入预览版需额外开通 Token Plan 订阅、使用其专属 API Key,并在计费与告警逻辑中区分两套体系。
四、模型特征
4.1 官方披露的四个升级方向
阿里千问团队在 2026 年 11 月 11 日的官宣中,将 Qwen4 的升级方向概括为三点表述:知识理解更深入、世界感知更立体、Coding 与 Agentic 能力持续进阶。凤凰网科技同日报道进一步归纳为四个方向:知识理解、世界感知、编程能力、智能体能力,并指出覆盖复杂编程、专业办公、前端设计和专业软件操作等任务。
4.2 从"问答交互"转向"完成实际任务"
这是本次升级中最具方向性的一点。据阿里方面介绍,相比传统的问答交互,Qwen4 更加注重完成实际任务,能够支持复杂代码编写、前端页面设计、专业办公及软件操作等工作。官方在预告中直接使用了"专为真实任务打造"的表述,并邀请用户"把真实难题交给 Qwen4 试试看"。
这一转向与行业评价体系的变化同向:衡量标准从"回答得多好"转向"任务完成得多好",从单轮对话质量转向长链路执行成功率。对使用者的实际含义是,评估该模型时不应以通用问答的观感为主要依据,而应以自己业务中的完整任务链路(含工具调用、多步骤执行、结果交付)作为测试单元。
4.3 家族成员的第三方评测表现
在 Qwen4-Max 预览版上线前,第三方评测榜单 GameFeel Bench(一个面向游戏开发场景创造力的垂直基准,考察游戏手感、视觉呈现与创意构思)v1.4 版本中出现了两个未公开型号,业界普遍认为对应 Qwen4 的早期内测版本。据 2026 年 11 月 8 日至 10 日的多家媒体报道:
| 模型(榜单标识) | GameFeel Bench 得分 | 对照模型得分 | 单次任务成本 |
|---|---|---|---|
| Qwen-4-Flash-Early(代号 hawk) | 49.9 | Claude Opus 5.5 (XHigh) 47.2;Claude Sonnet 5.5 (Max) 45.0 | 约 0.40 美元 |
| Qwen-4-27B-Early | 44.6 | Claude Sonnet 5.5 为 45.0 | 约 0.16 美元 |
| Claude Opus 5.5(对照) | 47.2 | — | 约 2.60 美元 |
对这组数据必须附加三点限定:其一,这是第三方垂直榜单,不是通用能力基准;其二,参评的是早期内测版本,不等于正式版或 Max 版;其三,榜单中并未出现 Qwen4-Max 的得分。因此这组数据只能说明 Qwen4 家族在游戏开发类创意任务上具备竞争力,不能用来推断 Qwen4-Max 的具体能力水平。
一个可核查的补充事实:有海外开发者公开分享,仅用一次生成、消耗 69k Tokens,就通过 Java 与 Three.js 完成了一段 3D 渲染,这与官方提到的"3D 建模、网页设计、交互"内测成果方向一致。
五、模型能力
以下按能力维度展开,并逐项区分官方定性表述与可验证数据。
5.1 知识理解与推理
官方表述:知识理解更深入。据媒体归纳,具体指向对专业文献、行业文档与复杂逻辑题的推理能力提升,长文本精读、信息溯源与复杂问题拆解更精准。
文档记录:属于推理模型,支持深度思考模式;百炼能力标签包含"模型推理"。
可验证数据:尚未公布。 官方未披露 Qwen4-Max 在 GPQA、SuperGPQA、MMLU 等知识类基准上的得分,也未给出与 Qwen3-Max 的对比数值。
代际参照:上一代 Qwen3-Max-Thinking(2026 年 1 月 26 日发布)在启用工具的 HLE(Humanity's Last Exam)评测中得分 58.3,超过 GPT-5.2-Thinking 的 45.5 与 Gemini 3 Pro 的 45.8;在 IMO 难度级别的 IMO-AnswerBench 上得分 91.5。这组数字属于 Qwen3 代际的公开成绩,不代表 Qwen4-Max 的表现。
5.2 世界感知与多模态
官方表述:世界感知更立体。
文档记录:输入模态支持文本、图像、视频;百炼模型清单标注"视觉理解"能力标签并标记为 New。
据媒体归纳,其优化重点包括图像、图表、截图、文档混合输入的解析,以及图表数据提取、图纸解读、图文混排文档分析。开发者内测反馈集中在 3D 建模、网页设计与交互呈现方面。
尚未公布的部分:图像分辨率与视频时长上限、多模态上下文长度、是否为原生多模态架构(区别于外挂视觉编码器)、以及视频输入在预览期的可用性范围。
5.3 编程能力(Coding)
这是本次升级的两个重点之一。官方表述为 Coding 能力持续进阶,凤凰网科技报道称编程能力是本次升级的重点,可支持复杂代码编写。
具体能力范围据媒体与开发者社区归纳包括:复杂工程代码生成、调试与重构,多文件项目统筹,前端交互页面与全栈项目交付,深层 bug 的定位与修复。内测成果集中体现在 3D 建模、网页设计与交互实现上。
一个可核实的落地信号:Qoder 官方宣布,此前供用户测试的匿名模型 Qoduck 已升级为 Qwen4-Max-Preview,并率先在 Qoder 上线;在此前四天的匿名测试中,Qoduck 每天都更新。此次开放覆盖 Qoder 的全部产品和全部套餐,包括 Teams 与 Enterprise。匿名测试再揭榜的做法,本身构成了对模型编程能力的一种盲测背书——用户在不知道模型身份的情况下完成了四天的真实使用,这比事后公布的跑分更接近生产环境的表现。
代际参照:上一代 Qwen3.8-Max-0902 版本(2026 年 9 月 2 日升级)在 CodeArena 前端编程总榜以 1691 分登顶,TerminalBench 得分从 11.3 提升至 29.0。Qwen4-Max 在同类榜单上的成绩官方尚未公布。
5.4 智能体能力(Agentic)
这是本次升级的另一个重点。官方表述为 Agentic 能力持续进阶,强调相比传统问答交互更注重完成实际任务,可支持专业办公与专业软件操作。
据媒体与开发者社区归纳,具体指向:长任务拆解、多步骤闭环执行、子智能体调度、工具调用稳定性提升、软件界面操作与跨工具串联任务。
文档记录的工具能力为 Function Calling、联网搜索、网页抓取、代码解释器,并支持 JSON Schema 结构化输出——后者对智能体链路的稳定性有直接价值,因为字段结构可被预先约束,减少解析失败。
前代技术积累:Qwen3-Max-Thinking 已引入自适应工具调用能力,可在对话中自主选择并调用内置的搜索、记忆与代码解释器功能,其训练方式是在工具使用微调后,用基于规则和基于模型的反馈在多样化任务上进一步训练。Qwen4 在此基础上强调"专业软件操作",意味着智能体的动作空间从"调用 API 类工具"扩展到"操作图形界面软件",任务链更长、动作类型更复杂。
5.5 能力维度的确认状态汇总
| 能力维度 | 官方定性表述 | 平台文档记录 | 量化跑分 | 状态 |
|---|---|---|---|---|
| 知识理解与推理 | 知识理解更深入 | 推理模型、深度思考模式 | 未公布 | 定性可确认,定量待披露 |
| 世界感知与多模态 | 世界感知更立体 | 支持文本、图像、视频输入 | 未公布 | 多模态输入已确认,细节待披露 |
| 编程能力 | Coding 持续进阶 | 复杂推理与编程、代码解释器 | 未公布 | 定性可确认,已有 Qoder 盲测背书 |
| 智能体能力 | Agentic 持续进阶 | Function Calling、三类内置工具、JSON Schema | 未公布 | 工具规格已确认,成功率指标待披露 |
| 结构化输出 | — | 支持 JSON Object 与 JSON Schema | — | 已确认 |
| API 兼容性 | — | 兼容 OpenAI 与 Anthropic 协议 | — | 已确认 |
| 参数规模 | — | — | 未公布 | 完全未披露 |
| 上下文窗口 | — | — | 未公布 | 完全未披露,网传数值不可采信 |
| 是否开源 | — | — | 未公布 | 完全未披露 |
六、适用场景
6.1 官方明确指向的四类任务
据 2026 年 11 月 11 日的官方表述与媒体报道,Qwen4-Max 覆盖的任务类型为:复杂编程、专业办公、前端设计、专业软件操作。平台文档同时提及,该模型适合对推理和理解能力要求更高的任务,在模型选型建议中被列为"效果优先"选项。
6.2 按用户角色的场景映射
| 用户角色 | 典型任务 | 推荐入口 |
|---|---|---|
| 独立开发者 | 复杂代码项目、批量脚本、Web 全栈开发、深层 bug 修复 | Token Plan(qwen4-max-preview)+ Claude Code / Qwen Code / Cursor |
| 团队与企业开发 | 多文件工程联动、代码重构、自动化测试、Agent 工作流 | Qoder(含 Teams / Enterprise 套餐) |
| 前端与设计师 | 网页设计、交互页面实现、3D 建模、可视化呈现 | Qoder、QwenStudio |
| 办公人群 | 文档撰写与解读、表格处理、文献研读、方案与报告生成 | 千问办公、千问 APP |
| 智能体开发者 | 提示词调试、Agent 链路测试、工具调用编排、长任务自动化 | QwenStudio、Token Plan API |
| 企业与科研机构 | 新模型能力评估、场景验证、提前适配 | Token Plan 预览期测试 |
| 多模态任务需求方 | 图表数据提取、图纸解读、图文混排文档分析、视频内容理解 | Token Plan API(图像与视频输入) |
6.3 不建议使用预览版的五类场景
基于预览版的版本属性,以下场景应保持谨慎:
- 不可中断的生产业务:预览版将于 2026 年 11 月 25 日 24:00 下线,模型标识会变更,直接上线存在改造风险。
- 对输出稳定性有强一致要求的场景:预览版定位为验证新能力与收集反馈,正式版可能调整行为。
- 需要长上下文处理的任务:上下文窗口未公布,无法评估是否满足需求。
- 需要私有化部署或开源权重的场景:是否开源尚未披露。
- 有明确合规与 SLA 要求的企业采购:应等待正式商用版本及其服务条款;同时注意当前仅支持 Token Plan 调用,不支持按量付费,无法满足以按量计费为前提的采购与结算流程。
七、与 Qwen3-Max 及其他模型的对比
7.1 千问旗舰模型的迭代脉络
| 模型 | 发布时间 | 参数规模 | 上下文 | 关键技术特征 | 公开成绩 |
|---|---|---|---|---|---|
| Qwen3-Max | 2025 年 9 月 24 日(云栖大会) | 超 1 万亿 | 256K | 分 Instruct 与 Thinking 两版;预训练数据 36T tokens | LMArena 文本榜预览版领先;SuperGPQA、AIME25、LiveCodeBench v6、Arena-Hard v2、LiveBench 超越 Claude-Opus 4(Non-Thinking)、Kimi-K2、DeepSeek-V3.1 |
| Qwen3-Max-Thinking | 2026 年 1 月 26 日 | 超 1 万亿 | 256K | 自适应工具调用;测试时扩展(经验提取式多轮自我反思) | 19 项基准媲美 GPT-5.2-Thinking、Claude Opus 4.5、Gemini 3 Pro;HLE(w/ tools) 58.3;IMO-AnswerBench 91.5 |
| Qwen3.8-Max | 2026 年 8 月发布并开源,9 月 2 日升级 0902 版 | 2.4 万亿(MoE,推理激活约 950 亿) | 100 万 Token | 混合专家架构;开放权重;围绕编程与专业办公做后训练 | CodeArena 前端编程总榜 1691 分登顶;TerminalBench 由 11.3 升至 29.0 |
| Qwen4-Max(预览版) | 2026 年 11 月 11 日 | 尚未公布 | 尚未公布 | 多模态输入(文本/图像/视频);深度思考;JSON Schema;四方向能力升级 | 官方尚未披露跑分与量化对比 |
7.2 可确认的八项差异
在官方与平台文档已披露的信息范围内,Qwen4-Max 相对 Qwen3-Max 的差异体现在以下八个方面:
其一,产品目标从"回答"转向"完成任务"。 Qwen3-Max 的定位是"适合复杂任务,能力最强"的通用旗舰文本模型,其公开成绩集中在知识与推理类基准(SuperGPQA、AIME25、GPQA、HLE)。Qwen4 官方明确表述为"相比传统的问答交互,新模型更加注重完成实际任务",评价重心转向复杂编程、专业办公、前端设计与专业软件操作。
其二,多模态能力从外挂型号转为旗舰内置。 Qwen3-Max 在通义实验室的模型家族介绍中标注为"输入:文本,输出:文本",视觉理解由 Qwen3-VL-Plus 等专门型号承担。而 qwen4-max-preview 的文档记录明确支持文本、图像、视频三种输入模态,百炼模型清单亦标注"视觉理解"标签。这意味着需要图文混合处理的任务,不再必须拼接两个模型。需要补充的是,Qwen3-Max 系列在部分文档中被归类为"千问Max(思考模式)",且仅在 Chat Completions API / DashScope 下推荐用于思考模式场景,其多模态支持情况需以对应模型文档为准。
其三,结构化输出规格更完整。 Qwen4-Max 系列同时支持 JSON Object 与 JSON Schema 两种结构化输出;Qwen3-Max 系列在部分场景下仅支持非思考模式的结构化输出。对需要将模型输出直接接入下游系统的工程链路而言,这一差异会影响校验逻辑的复杂度与链路失败率。
其四,智能体能力的深度不同。 Qwen3-Max-Thinking 的 Agent 能力体现为自适应工具调用,即在对话中自主选用搜索、记忆与代码解释器。Qwen4 强调的"专业软件操作",动作空间从 API 类工具扩展到软件界面操作与跨工具串联,属于任务链更长、动作类型更复杂的层级。
其五,发布与交付方式不同。 Qwen3-Max 走"云栖大会发布 → 百炼 API 上线 → Qwen Chat 免费体验"的路径;Qwen4-Max 走"预览版先进入 Token Plan 计费平台 → 同步接入四类应用 → 收集反馈后再发正式版"的路径。用户接触新模型的时间点明显提前。
其六,计费体系不同。 Qwen3-Max 采用按 Token 阶梯计价(据阿里云百炼价格页,qwen3-max 在 0—32K 输入区间为 2.5 元/百万 Token 输入、10 元/百万 Token 输出,32K—128K 为 4 元与 16 元,128K—252K 为 7 元与 28 元)。Qwen4-Max 预览版则通过 Token Plan 的 Credits 订阅制提供,且当前仅支持 Token Plan,不支持按量付费。两者属不同计费体系,单价不可直接换算比较。
其七,可用性周期不同。 Qwen3-Max 为长期在售的稳定商用模型;Qwen4-Max 当前为限时预览,窗口期 14 天 14 小时后下线。二者的服务承诺不在同一层级。
其八,模型标识管理方式不同。 Qwen4-Max 预览版提供主 ID 与别名(qwen4-max-preview / qwen4.0-max-preview)双标识,且明确预览结束后将以新模型名发布正式版。Qwen3-Max 系列则采用日期版本号形式(如 qwen3-max-2026-01-23、qwen3-max-2025-09-23)保持长期可调用。对接入方而言,前者需要预留标识切换的改造空间。
7.3 无法确认、不应推断的六项
以下问题在 2026 年 11 月 11 日时点均无官方答案:
- Qwen4-Max 的参数规模是否超过 Qwen3.8-Max 的 2.4 万亿;
- 上下文窗口是否大于 Qwen3-Max 的 256K 或 Qwen3.8-Max 的 100 万 Token;
- 在 HLE、GPQA、LiveCodeBench、SWE-bench 等基准上是否超过 Qwen3-Max-Thinking;
- 是否延续 MoE 架构及激活参数规模;
- 是否开源、采用何种许可证(Qwen3.8-Max 采用专用许可证,Qwen3.8-27B 为 Apache 2.0,Qwen4 系列尚未说明);
- 正式版发布时间与 API 按量定价。
需要特别强调第三点:"Qwen4-Max 相比 Qwen3-Max 提升了多少"这个问题,在官方数据披露之前没有可靠答案。 任何给出具体百分比或分数差值的说法,都应核查其数据来源是否为官方发布。
7.4 与同代家族成员的横向关系
Qwen4 家族内部的分工可参照已曝光的信息推断其定位区间:Max 主打性能上限,Plus 为均衡档,Flash 为低成本高速档(GameFeel Bench 49.9 分、单次任务约 0.40 美元),27B 面向本地部署(44.6 分、约 0.16 美元)。
对成本敏感的场景,Flash 与 27B 的性价比数据更具参考意义;对复杂工程与长链路 Agent 任务,才需要 Max 档的能力。用 Max 去跑 Flash 能胜任的任务,属于明确的成本浪费。 在 Token Plan 的 Credits 计量体系下,这一浪费会直接体现为额度消耗速度,而非事后账单,因此更需要在接入前完成档位规划。
7.5 与其他厂商旗舰模型的关系
在 Qwen4-Max 自身跑分未公布的情况下,可参考的横向锚点只有家族其他成员的第三方数据:GameFeel Bench v1.4 中,Qwen4-Flash 早期内测版以 49.9 分高于 Claude Opus 5.5 (XHigh) 的 47.2 分,成为该榜单上首个领先 Opus 5.5 的国产大模型;成本上,Opus 5.5 单次任务约 2.60 美元,Qwen4-Flash 约 0.40 美元,为其约 15%。
必须强调三点限定:这是垂直榜单(游戏开发创意)而非通用基准;参评的是 Flash 内测版而非 Max;成本数字来自榜单维护方口径。据此推断"Qwen4-Max 全面超越 Opus 5.5"缺乏依据。
作为上一代的参照,Qwen3-Max-Thinking 在 19 项基准上整体表现与 GPT-5.2-Thinking、Claude-Opus-4.5、Gemini 3 Pro 相近,在启用工具的 HLE 上以 58.3 分领先(较 GPT-5.2-Thinking 高 12.8 分、较 Gemini 3 Pro 高 12.5 分)。这是 Qwen3 代际的可核查成绩。
八、获取方式、渠道与计费
8.1 五个体验入口
| 入口 | 适用人群 | 说明 |
|---|---|---|
| Token Plan(千问 AI 平台 / 阿里云百炼) | 开发者 | 首发渠道,模型名 qwen4-max-preview,按 Credits 计量,当前唯一支持的计费方式 |
| Qoder | 开发者、团队与企业 | 覆盖全部产品与全部套餐,含 Teams 与 Enterprise |
| 千问办公 | 办公人群 | 会员用户可限时免费调用 Qwen4-Max 预览版 |
| 千问 APP | 普通用户 | 更新至最新版本后在模型选择界面切换;为云端模型,不支持离线调用 |
| QwenStudio | 智能体开发者 | 用于调试提示词、测试智能体链路 |
8.2 工具兼容性
Token Plan 兼容 OpenAI 与 Anthropic 协议,任何支持自定义 Base URL 与 API Key 的工具均可接入,包括 Claude Code、Cursor、Qwen Code、Qoder、Qoder CN、Cline、OpenClaw、Cherry Studio、Chatbox 等。
8.3 优惠口径
模型侧优惠:Qwen4-Max 预览版限时 2 折,新用户在此基础上再享 5 折,叠加后最低为原价的 1 折。折扣关系可核验:0.2 × 0.5 = 0.1,即 1 折。Qoder 侧同步给出限时优惠,Credits 消耗倍率为 0.1 倍,与 1 折口径一致。此外,千问系列模型在 Token Plan 中普遍适用夜间折扣机制(每日 22:00 至次日 08:00),具体倍率以平台页面为准。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
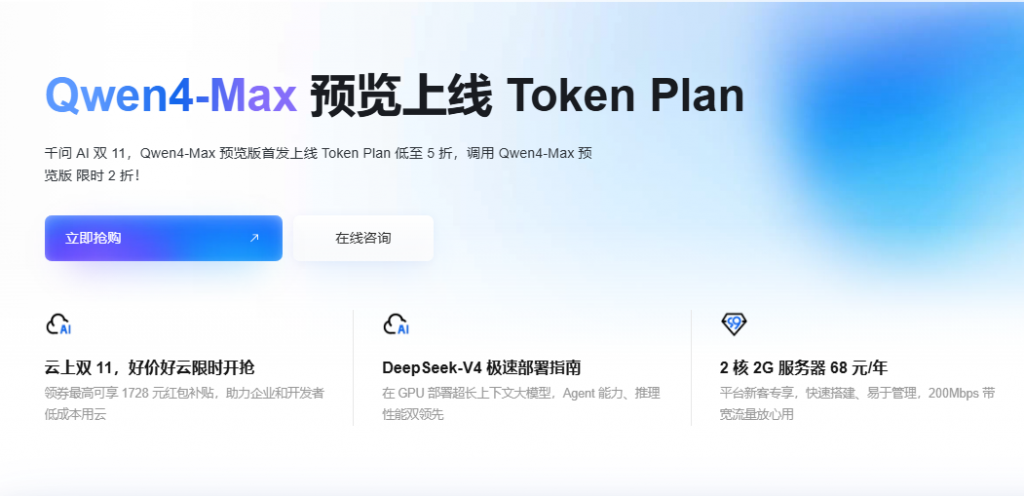
需要明确一点:模型折扣与订阅费是两笔账,不应混算。订阅费决定每月可用的 Credits 总额,模型折扣决定单次调用消耗多少 Credits。二者相乘才构成实际成本。
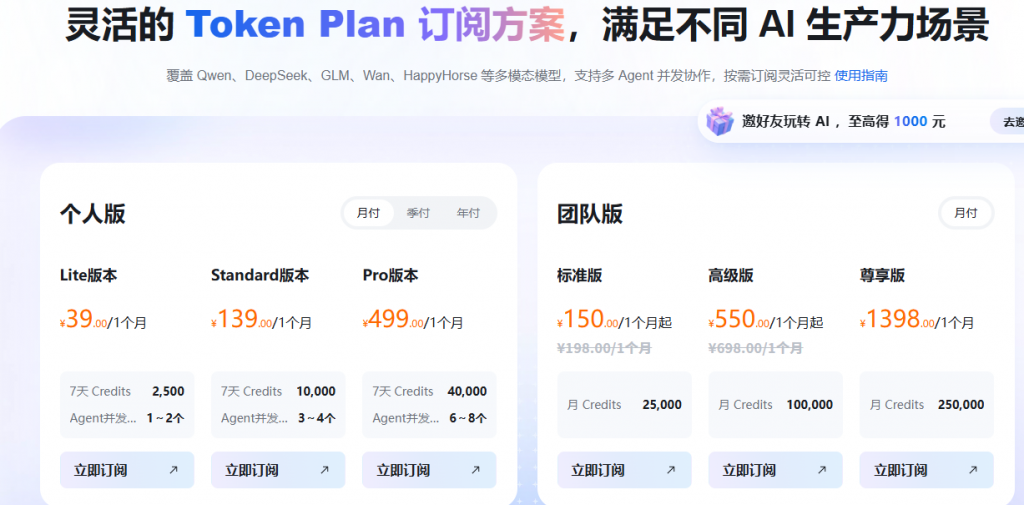
8.4 个人版订阅档位(2026 年 11 月 9 日调整后,日常价口径)
| 档位 | 月费 | 每月 Credits | 并发 Agent | 单位 Credits 成本(月费 ÷ Credits) |
|---|---|---|---|---|
| Lite | 39 元 | 20,000 | 1—2 个 | 0.00195 元/Credit |
| Essential | 79 元 | 45,000 | 2—3 个 | 约 0.00176 元/Credit |
| Standard | 139 元 | 80,000 | 3—4 个 | 约 0.00174 元/Credit |
| Pro | 312 元 | 200,000 | 6—8 个 | 0.00156 元/Credit |
此次调整的幅度经核算可验证:
| 档位 | 调整前额度 | 调整后额度 | 额度增幅 | 月费变化 |
|---|---|---|---|---|
| Lite | 11,500 Credits | 20,000 Credits | +73.9% | 39 元,不变 |
| Essential | 25,500 Credits | 45,000 Credits | +76.5% | 79 元,不变 |
| Standard | 45,000 Credits | 80,000 Credits | +77.8% | 139 元,不变 |
| Pro | 180,000 Credits | 200,000 Credits | +11.1% | 499 元 → 312 元,降幅 37.5% |
上述增幅与"Lite、Essential、Standard 三档月度额度提升约 74%—78%"的表述一致。Pro 档因额度与价格同时调整,单位 Credits 成本由 499 ÷ 180,000 ≈ 0.00277 元降至 312 ÷ 200,000 = 0.00156 元,降幅约 43.7%,是四档中单位成本下降最明显的一档。调整覆盖存量订阅用户,新额度自 11 月 9 日起陆续生效;Pro 存量用户当前订阅周期价格不变,新价格从下一订阅周期开始执行。
8.5 双 11 活动价口径(另行计算)
据阿里云开发者社区 2026 年 11 月 8 日的活动说明,Token Plan 新客首购低至 5 折,Lite 档折算后约 19.5 元/月,活动持续至 11 月 30 日。按该口径计算,Lite 档单位 Credits 成本为 19.5 ÷ 20,000 ≈ 0.000975 元/Credit,恰为日常价的一半。此口径与日常价属不同价格体系,实际以下单页面为准。
8.6 团队版口径
| 席位类型 | 原价 | 限时价 | 每月 Credits | 单位 Credits 成本(限时价口径) |
|---|---|---|---|---|
| 标准席位 | 198 元/席位/月 | 150 元 | 25,000 | 0.006 元/Credit |
| 高级席位 | 698 元/席位/月 | 550 元 | 100,000 | 0.0055 元/Credit |
| 尊享席位 | 1,398 元/席位/月 | — | 250,000 | 约 0.0056 元/Credit |
团队版的单位 Credits 成本(约 0.0055—0.006 元)显著高于个人版(约 0.00156—0.00195 元),差额对应的是团队版提供的额外权益:多席位管理与用量分析、多租户隔离架构(高峰期不排队)、席位级独立 API Key、以及承诺不使用对话数据训练模型。
最后一条对企业选型具有决定性意义:个人版的数据用于服务改进与模型优化,团队版承诺不用于训练。涉及商业机密、客户数据或受合规约束的业务,应选择团队版,此时单位成本差异不应作为主要决策依据。
8.7 计费机制要点
- 额度重置:Credits 按月重置,订阅月内未用完的额度不结转至下一周期。
- 抵扣顺序:优先抵扣当前订阅月的套餐额度;用尽后自动抵扣加油包额度;加油包用尽或未持有时服务暂停,可升级档位或等待下一订阅月重置。
- 加油包:个人版 100 元/个,含 20,000 Credits,最多同时持有 5 个,需先订阅有效套餐后购买;团队版 5,000 元/个,含 625,000 Credits,跨席位共享,有效期 1 个月,到期未用清零。个人版加油包的单位成本为 100 ÷ 20,000 = 0.005 元/Credit,约为 Pro 档日常价的 3.2 倍,因此加油包应定位为应急手段,而非长期扩容方案;若连续多月需要加油包,升级档位更经济。
- 消耗构成:单次消耗的 Credits 由模型类型、Token 用量、思考模式及工具调用等动态决定,实际以平台用量统计为准。
- 体系隔离:Token Plan 与按量付费是两套独立体系,额度互不通用。
更多 Token Plan 活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
8.8 预览期成本估算方法
由于官方未公布 qwen4-max-preview 的 Credits 消耗倍率明细,建议采用实测法而非估算法:
- 在最低档位(Lite,39 元/月、20,000 Credits)下开通订阅;
- 选取 3—5 个代表自身业务的真实任务,各执行一次,记录执行前后的 Credits 余额差值;
- 计算单任务平均消耗 C,并按月度任务量 N 估算月消耗 = C × N;
- 对照各档位的每月 Credits 上限选择档位,预留 20%—30% 余量以应对任务复杂度波动;
- 注意开启深度思考模式与调用内置工具都会增加消耗,估算时应按实际使用的模式取样。
该方法的优势在于结果直接来自自身业务负载,不受模型定价未公布的影响。
九、选型建议
9.1 应该选 Qwen4-Max 预览版的五种情况
- 需要评估下一代旗舰能力:在预览窗口期(至 2026 年 11 月 25 日 24:00)内用真实任务测试,为正式版上线做准备。
- 任务是复杂编程或长链路 Agent:多文件工程、代码重构、前端与 3D 实现、跨工具自动化,这是官方明确指出的升级重点。
- 需要多模态输入与推理结合:预览版支持文本、图像、视频输入,适合图表解析、图纸解读、图文混排文档分析等任务。
- 需要严格的结构化输出:同时支持 JSON Object 与 JSON Schema,可减少后置校验逻辑。
- 已在 Qoder、千问办公生态内:这些产品已完成接入,切换成本低,且 Qoder 覆盖全部套餐(含 Teams 与 Enterprise);叠加最低 1 折的力度,试错成本很低。
9.2 应该继续使用其他模型的七种情况
| 需求特征 | 建议模型 | 理由 |
|---|---|---|
| 生产环境、需要稳定 SLA | Qwen3-Max / Qwen3.8-Max 正式版 | 预览版将下线,正式版有稳定商用承诺 |
| 数学与科学推理的极致表现 | Qwen3-Max-Thinking | HLE(w/ tools) 58.3、IMO-AnswerBench 91.5 为已公开的可核查成绩 |
| 需要开源权重与私有化部署 | Qwen3.8-Max(2.4T MoE,激活约 950 亿)或 Qwen3.8-27B | 已开源;Qwen4 是否开源未公布 |
| 需要明确的长上下文规格 | Qwen3.8-Max(100 万 Token)或 Qwen3-Max(256K) | Qwen4-Max 上下文未公布,无法确认 |
| 高频低成本调用 | Qwen-Plus / Qwen-Flash 或 Qwen4-Flash | 单价与 Credits 消耗显著更低 |
| 本地部署、数据不出域 | Qwen4-27B(正式版发布后)或 Qwen3.8-27B | 中等规模,Apache 2.0(3.8-27B) |
| 明确按量计费、不做订阅 | Qwen3-Max 系列按 Token 计价 | qwen4-max-preview 当前仅支持 Token Plan,不支持按量付费 |
9.3 预览期的六项实操建议
- 用真实难题测试,而非跑通用问答:官方明确邀请"把真实难题交给 Qwen4 试试看",只有真实任务才能暴露预览版的边界。
- 在预览期内完成基准记录:预览期不做变更,是获得一致性、可复现测试结果的窗口;应记录典型任务的 Credits 消耗、成功率与输出质量,供正式版对比。
- 配置用量告警:套餐额度用尽后服务可能暂停或触发加油包抵扣,应设置月度与日度上限。
- 批量任务安排在夜间:千问系列模型有夜间折扣机制(每日 22:00 至次日 08:00),非实时任务可利用该时段降本。
- 预留模型名切换的改造工作量:
qwen4-max-preview在 11 月 25 日 24:00 后下线,接入代码需支持模型标识可配置,避免硬编码。 - 数据敏感业务选团队版:团队版承诺不使用对话数据训练模型,个人版数据用于服务改进与模型优化。
9.4 正式版迁移的准备清单
为降低预览版下线带来的改造成本,建议在预览期内完成以下六项准备:
| 准备项 | 具体动作 |
|---|---|
| 模型标识参数化 | 将模型名写入配置文件或环境变量,不硬编码在业务代码中 |
| 双标识兼容 | 同时验证 qwen4-max-preview 与 qwen4.0-max-preview 的调用一致性 |
| 能力基线记录 | 保存典型任务的输入、输出、Credits 消耗与成功率,作为正式版对比基线 |
| 降级链路 | 预置 Qwen3-Max 或 Qwen3.8-Max 的回退配置,避免预览版下线导致服务中断 |
| 计费隔离 | 在成本核算中区分 Token Plan 与按量付费两套体系 |
| 提示词归档 | 记录在预览版上调优后的提示词版本,正式版行为变化时可快速回溯 |
十、风险提示与结论
10.1 五项风险提示
- 时效风险:预览版于 2026 年 11 月 25 日 24:00(UTC+8)下线,此后模型标识不可用,正式版发布时间官方尚未公布。
- 规格不确定风险:参数规模、上下文窗口、基准跑分均未披露,无法据此评估是否满足特定技术要求。
- 计费单一风险:当前仅支持 Token Plan,不支持按量付费,未订阅账号无法调用;Credits 按月重置且不结转,用量规划不当会造成额度浪费。
- 数据合规风险:个人版数据用于服务改进与模型优化,团队版承诺不用于训练;涉密或受监管业务须选择团队版。
- 信息误读风险:Qwen3.8-Max 的 2.4 万亿参数与 100 万 Token 上下文属于该型号,不可套用至 Qwen4-Max;GameFeel Bench 上领先 Opus 5.5 的是 Qwen4-Flash 内测版而非 Max,且属游戏创意垂直榜单。
10.2 结论
Qwen4-Max 是千问第四代的旗舰模型,当前以预览版形态(qwen4-max-preview,别名 qwen4.0-max-preview)通过 Token Plan 首发,并接入千问办公、Qoder、千问 APP 与 QwenStudio,预览窗口期为 2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00(UTC+8)。
从技术规格看,它是一款支持文本、图像、视频输入的推理模型,具备深度思考模式、Function Calling 与三类内置工具、JSON Object 与 JSON Schema 双结构化输出,并兼容 OpenAI 与 Anthropic 协议。这套规格组合指向的是同一个使用方式:作为智能体链路中的核心推理与执行单元,而非单纯的对话模型。
它的核心变化不在于参数规模的数字,而在于产品目标的转向:从"把问题回答好"转向"把任务完成好"。官方明确的四个升级方向——知识理解、世界感知、编程能力、智能体能力——都指向复杂编程、专业办公、前端设计与专业软件操作这类真实工作场景。Qoder 将匿名测试四天的 Qoduck 揭榜为 Qwen4-Max-Preview,是这一转向在编程能力上的具体佐证。
相对 Qwen3-Max,可确认的差异有八项:目标从问答转向任务完成、多模态能力从外挂型号转为旗舰内置、结构化输出规格更完整、Agent 能力从工具调用扩展到软件操作、发布方式改为"预览先行、反馈驱动"、计费从按 Token 阶梯计价转为 Token Plan 订阅、可用性从长期在售转为限时预览、模型标识从日期版本号转为预览标识加别名。
同样需要如实说明的是,Qwen4-Max 的参数规模、上下文窗口、基准跑分、与上一代的量化对比、开源计划与 API 按量定价,截至目前均未公布。因此,"相比 Qwen3-Max 提升了多少"这个问题,在官方数据披露之前没有可靠答案。第三方榜单 GameFeel Bench 上 Qwen4-Flash 与 Qwen4-27B 内测版的成绩(49.9 分与 44.6 分)说明该家族具备竞争力,但不能替代 Max 版的实测数据。
对使用者而言,理性的做法是:在预览期内用最低 1 折的成本,把自己手上最难的任务交给它跑一遍,记录 Credits 消耗、成功率与输出质量,形成属于自己业务场景的评估结论,并同步完成正式版迁移的六项准备。这比等待任何榜单都更可靠——因为模型的价值最终由它能否完成你的任务来定义,而不是由参数规模或跑分排名来定义。