阿里云千问大模型(Qwen)体系涵盖文本生成、视觉理解、图片生成、视频生成、语音识别与合成等多模态能力,包含闭源与开源两大系列,通过大模型服务平台百炼统一提供调用。千问大模型平台详情:https://www.aliyun.com/product/tongyi
1、文本生成模型
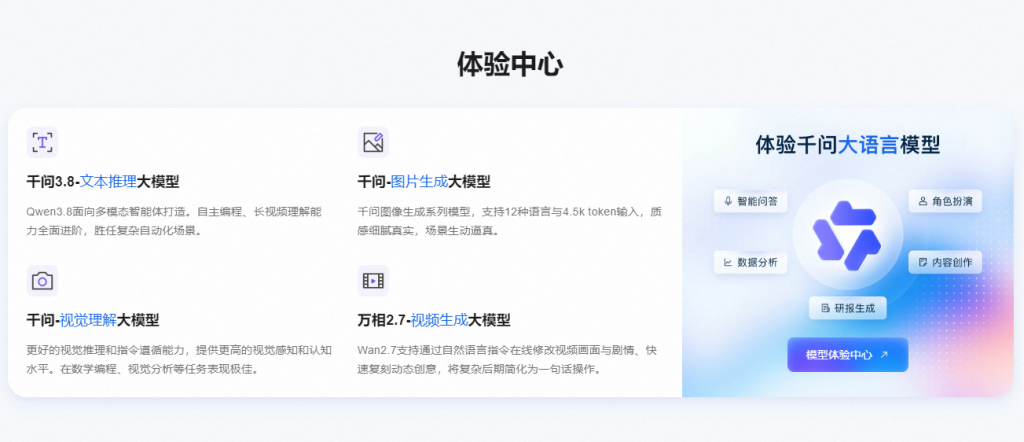
- Qwen3.8-Max:多模态旗舰模型,支持自主编程、视觉理解与 Agent 自动化,适用于复杂推理场景;其快照版本 Qwen3.8-Max-0902 在 Coding、Cowork 协作与视觉理解方面进一步升级。
- Qwen3.8-Flash:支持百万级上下文窗口,可一次性处理超长文档和代码仓库。
- Qwen3-VL-Plus:视觉语言模型,在视觉 Coding、空间感知、多模态思考等方面升级。
- Qwen3.7-Plus:支持文本生成、深度思考与视觉理解,上下文长度为 1M。
- 历史版本:通义千问3、通义千问-Max、通义千问-Plus、通义千问-Turbo 等仍属于千问大模型家族成员。
2、全模态与实时交互模型
- Qwen3.8-Omni-Flash:新一代全模态模型,支持 1M 长序列,文本、图像、音视频同框输入与空间音频解析。
- Qwen3.8-Omni-Flash-Realtime:实时全模态交互模型,支持 60+ 语言识别、30+ 语言语音生成及 Function Call、MCP 工具编排,面向智能硬件、机器人与实时交互 Agent。
- Qwen3.8-LiveTranslate-Flash:多语言实时音视频同传模型,支持听懂 60 种语言、会说 29 种语言。
3、** 图片生成模型**
- Qwen-Image-3.0-Pro / Qwen-Image-3.0:支持复杂版面一次生成与小字准确渲染,覆盖 12 种语言、20+ 字体原生渲染,细节真实。
4、视频生成模型
- Wan3.0-Video:原生支持 30 秒视频生成,融合图、文、视频、音频四种模态参考。
- Wan3.0-Video-Prime:Wan3.0 高速版,端到端速度显著提升。
- Wan2.7-R2V:参考生视频模型,支持图/视频混合参考与音频音色参考。
- HappyHorse-1.1-T2V:文字生成高质量视频模型。
5、语音识别与合成模型
- Qwen3-TTS-Flash / Qwen-Audio-3.1-TTS-Flash:语音合成大模型,支持多语言方言、指令遵循与细粒度标签控制。
- Cosyvoice-V3-Flash:高表现力语音合成模型,支持语音克隆。
- Qwen-Audio-3.1-ASR-Flash / Fun-ASR:语音识别模型,支持中英文自由切换、多方言、上下文增强与噪声鲁棒性。
6、开源与第三方模型
百炼平台同时提供开源千问模型及第三方模型(如 Kimi-K3、Deepseek-v4-pro、GLM-5.2 等),可在模型市场中统一调用。

一、千问大模型概述
1.1 产品定位
千问(Qwen)大模型是阿里云自主研发的大规模语言模型系列,也是阿里巴巴集团在人工智能领域的核心技术成果之一。自发布以来,千问大模型凭借稳定的性能表现与持续的技术迭代,已成为国内外最受关注的大模型产品之一,其应用范围覆盖自然语言处理、计算机视觉、多模态理解与生成等多个领域。
作为阿里巴巴集团在 AI 赛道上的战略性产品,千问大模型承载的不仅是技术突破的任务,同时也承担着推动 AI 技术普惠化、降低企业智能化转型门槛的职责。从最初的文本生成模型,到如今覆盖全模态的综合 AI 平台,千问大模型的发展轨迹,一定程度上反映了中国大模型产业从追赶到并跑、部分领域引领的演进过程。
1.2 三层结构:理解千问的正确框架
要把千问大模型看清楚,需要把它置于"模型家族—服务平台—行业应用"三层结构之中:
- 模型家族提供能力底座,决定模型"能做什么";
- 服务平台(阿里云百炼)提供接入与治理,决定模型"怎么被调用、怎么被管理、怎么被计费";
- 行业应用提供价值落点,决定模型"在真实业务中解决什么问题"。
三者相互耦合,构成了千问区别于单一模型产品的体系化竞争力。这一体系并非依靠参数堆叠形成,而是数据工程、算法框架、算力调度与产品化能力协同作用的结果:底层依托万亿级超大规模语料与领先的训练框架,上层则通过一站式平台把模型能力封装为可被开发者与企业直接调用的标准化服务接口。
1.3 五大核心优势
千问大模型的核心优势可归纳为五个方面,它们共同构成该系列在技术深度、能力广度与工程可用性上的综合壁垒。
第一,基础能力扎实。 千问大模型基于海量高质量数据完成预训练,在语言理解、逻辑推理、知识问答、代码生成等基础任务上表现优异。其参数规模覆盖数十亿到数千亿不等,能够匹配不同场景下的性能与效率需求。在多项国际权威基准测试中,千问大模型均取得领先成绩,尤其在中文理解与生成方面具备天然优势。无论是复杂的学术推理、专业的法律咨询,还是日常的对话交互,千问大模型都能给出准确、流畅且具备深度的回复。基础能力的厚度,决定了模型在面对长尾、专业、高难度任务时的鲁棒性,也是后续多模态与垂直能力得以稳定发挥的前提。
第二,模态覆盖完整。 千问大模型已从最初的纯文本模型,发展为涵盖视觉语言、视觉理解、图片生成、视频生成、全模态交互、语音识别等多种模态的综合模型家族。文本处理、图像分析、音视频理解等任务,千问系列均有对应支持。模态之间的协同——例如让一个模型同时"看懂"图像、"听懂"语音并"说出"回应——正是当前智能体(Agent)应用落地的关键基础设施。
第三,部署方式灵活。 千问大模型支持云端 API 调用、私有化部署等多种方式,用户可根据业务需求选择接入方案。对数据安全要求较高的企业,私有化部署可确保数据不出域,满足合规要求;对追求快速上线与弹性扩展的互联网应用,云端 API 调用提供了更便捷的接入路径。此外,模型微调、知识库增强等定制化服务,可帮助企业构建专属 AI 能力。部署形态的多样性,本质上是对"性能—成本—合规"三角约束的工程化回应。
第四,迭代节奏高频。 千问大模型团队保持高频更新节奏,持续推出性能更强的版本。从 Qwen1.0 到 Qwen3.8,每一代模型都在前代基础上实现显著能力提升,并伴随基准测试成绩与真实应用表现的同步改善。对开发者而言,高频迭代意味着选型时需要关注版本演进与接口兼容性,而非一次性锁定。
第五,生态体系开放。 千问大模型坚持开源与商业化并行,通过开源社区吸引大量开发者参与贡献与反馈,形成良性技术生态。开源与闭源旗舰并行,使个人研究者、初创团队与大型企业均能在同一技术谱系下找到适配自身资源条件的模型。
1.4 适用场景
千问大模型广泛服务于智能客服、内容创作、代码辅助、数据分析、教育学习、企业办公、创意生成等领域。从初创团队的快速原型验证,到大型企业的规模化 AI 应用部署,均可获得从模型选择、接入集成到运维支持的全链路服务。
进一步细分,不同模态与规格的模型对应差异化的场景重心:旗舰级文本模型面向高难度推理、长程任务与专业领域问答;轻量级 Flash / Plus 模型面向高并发、低延迟的在线服务与成本敏感型应用;图像与视频生成模型面向营销素材、影视预演、电商内容等创意生产链路;语音识别与合成模型面向智能外呼、会议转写、有声内容生成等交互场景;多模态与实时对话模型则面向具身交互、实时翻译、车载与终端助手等融合体验。
二、模型体系总览:191 款模型的能力谱系
阿里云百炼平台是面向开发者和企业的一站式大模型服务平台,汇聚了 191 款不同能力、不同规格的大模型产品,覆盖文本生成、多模态理解、图像生成、视频创作、语音交互等多种 AI 能力,能够满足从轻量级应用到重度生产环境的各类需求。从能力域划分,这 191 款模型大致可归入以下谱系。
2.1 通用文本与推理谱系
以 Qwen Max / Plus / Flash / Turbo / Long 等为代表,覆盖从旗舰到轻量的完整梯度,并包含 Coder、Character、Deep-Research、Rerank、Embedding 等专项能力。该谱系是调用量最大、规格最密的一支,通常按"输入/输出"每百万 token 计费,并按上下文长度实行阶梯定价。
2.2 全模态交互谱系
以 Qwen Omni 系列为代表,支持文本、图像、音频、音视频的统一理解与生成,并提供 Realtime 实时版本。该谱系适合语音与视觉融合的交互应用,也是实时对话、多模态 Agent 场景的底座。
2.3 视觉理解与 OCR 谱系
以 Qwen VL、Qwen OCR、GUI 等为代表,面向图像问答、文档解析、界面操作等任务。其中 OCR 类模型在文档解析、文本定位、关键信息提取方面持续升级,在身份证、驾驶证等真实卡证抽取场景中效果提升明显;GUI 系列则针对手机端与电脑端图形界面理解与交互任务设计。
2.4 语音谱系
以 Qwen Audio、CosyVoice、Fun-ASR、Paraformer、Sambert 等为代表,覆盖语音识别、语音合成、声音复刻、同声传译等链路。语音识别类模型多按音频时长(元/秒)计费,语音合成类模型多按字符数计费。
2.5 图像与视频生成谱系
以 Qwen Image、Wan(万相)系列、MiniMax、PixVerse、Kling(可灵)、Vidu、Tripo 等为代表,覆盖文生图、图生视频、视频编辑、3D 生成等能力。生成类模型通常按张或按秒计费,并发与 RPM 是规模化生产时必须关注的限流维度。
2.6 第三方与生态模型
以 DeepSeek、GLM、Kimi、MiniMax、StepFun、SiliconFlow、小米 MiMo、云知声等为代表,通过百炼统一接入,丰富选型空间。需要注意,模型 ID 中带 "/" 的多为第三方直供模型,调用前需先在控制台开通对应服务商的服务。
2.7 平台入口
这种"自研为主、生态为辅、全模态覆盖"的体系结构,使百炼平台能够以单一入口承接绝大多数企业级 AI 需求,避免开发者在多平台之间反复适配。平台详情入口:https://www.aliyun.com/product/tongyi

三、重点旗舰模型能力详解
3.1 Qwen3.8-Max:旗舰级全能大模型
Qwen3.8-Max 是千问系列中参数规模最大的旗舰模型,采用 2.4 万亿参数的 MoE(混合专家)架构,代表当前千问大模型家族的最高技术水平。该模型在编程与办公能力方面实现全面跃升,具备自主编程十数天交付完整项目的能力,这在业界属于较为罕见的长程自主工作能力。
在具体应用场景中,Qwen3.8-Max 能够胜任法律、金融、设计等数百种专业任务,一次对话即可端到端交付生产级成果,这意味着用户无需进行多轮反复调试,模型可在单次交互中完成从需求理解、方案设计到最终交付的完整流程。
该模型还具备原生视觉理解能力,并贯穿规划、执行与验证全流程,支持超长文档与长视频的深度语义解析。在长程任务中,模型能够自主规划与闭环迭代。其规格为上下文 1M、最大输出 131.1K;计费口径为输入 ¥12 / 百万 tokens、输出 ¥36 / 百万 tokens。
3.2 Qwen3.8-Flash:高性能轻量级多模态模型
Qwen3.8-Flash 兼具理解与生成能力和出色的响应速度,在设计之初即充分权衡效率与性能。模型原生支持百万级上下文窗口,可一次性处理超长文档、代码仓库和复杂对话,因而在大规模文本分析、代码审查、长对话管理等场景中优势明显,用户无需担心上下文截断问题。
在编程辅助、智能体协作、图文理解等场景中,Qwen3.8-Flash 表现突出:无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确结果。模型还兼容 OpenAI 与 Anthropic 主流接口协议,可接入 Claude Code、Codex 等开发者工具。其规格为上下文 1M、最大输出 131.1K;计费口径为输入 ¥0.8 / 百万 tokens、输出 ¥2.7 / 百万 tokens,是高并发在线服务的性价比之选。
3.3 Qwen3.8-Omni-Flash:全模态输入输出
Qwen3.8-Omni-Flash 在同一规格档位下扩展为全模态输入输出,并支持实时版本,面向语音与视觉融合的交互应用。计费口径与 Flash 同档,为输入 ¥0.8 / 百万 tokens、输出 ¥2.7 / 百万 tokens,上下文 1M、最大输出 131.1K。
3.4 Qwen3.8 开源模型(qwen3.8-2.4t-a95b):开源旗舰
Qwen3.8-2.4T-A95B 是千问最新旗舰系列的开源版本,于 2026 年 8 月正式发布。该模型采用稀疏 MoE 架构,总参数达到 2.4 万亿,每步激活约 950 亿参数,配合混合注意力机制,支持 100 万 Token 上下文。
在核心基准测试中,该模型取得 GPQA Diamond 92.6、PaperBench 93.0、OSWorld 86.1、BabyVision 82.0,CodeArena 全球第 4 的成绩,表明其在推理能力、学术理解、操作系统交互、视觉理解以及代码能力等方面均达到世界顶尖水平。开源版本的发布为研究社区和企业用户提供了更多可能性:研究者可进行进一步的微调和定制开发,企业则可在保障数据安全的前提下完成私有化部署。其规格为上下文 1M、最大输出 131.1K;计费口径为输入 ¥12 / 百万 tokens、输出 ¥36 / 百万 tokens。
3.5 Wan3.0-Video:高速视频生成
Wan3.0-Video-Prime 是万相 3.0 的高速版视频生成模型,能力对齐 Wan3.0-Video 标准版,支持四模态全能参考,最长可生成 30 秒视频,在带来沉浸式视听体验的同时,端到端速度显著提升。四模态全能参考意味着模型可同时参考文本描述、参考图片、参考视频以及音频信息来生成目标视频,从而提升创作的可控性与灵活性。定价为 ¥0.45–1.8 元/秒,RPM 300、并发 5,适用于短视频创作、广告制作、产品展示与创意内容生成。
3.6 Qwen-Image 系列:文生图主力
Qwen-Image-3.0 指令理解清晰,支持最大 4.5k token 输入,复杂图文指令一次生成到位;文字渲染稳定,10px 小字、12 国语言、20+ 字体清晰可辨;批量产出效率高,海报、网页、界面等日常任务可批量生成。Qwen-Image-3.0 与 Qwen-Image-2.1 覆盖文生图能力,单价低至 0.02–0.25 元每张,适合大规模素材生产。此外,Qwen-Image-2.0-Pro 实现了图片生成与图片编辑的融合,具备更专业的文字渲染与更强的语义遵循能力;Qwen-Image-Edit-Max 则提供更稳定、更丰富的编辑能力,并集成 Lora 能力。
3.7 智谱 GLM-5.3-Flash:原生多模态轻量旗舰
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型,以极致低成本架构实现超越 GLM-5.2 的更强智能。模型采用 320B 总参 / 18B 激活的稀疏 + 线性注意力混合架构,注意力计算量与 KV 缓存分别降低 3.01 倍和 4.44 倍。其视觉能力原生融入 Coding 循环,可主动观察界面、渲染结果与交互反馈,跨代码、浏览器与图形界面协同完成任务;同时拓展至 Office、金融研究及专业文档场景,能自主拆解目标、调用工具并优化输出,交付 PPTX、PDF、DOCX、XLSX 等高质量成品。计费口径为输入 ¥0.8 / 百万 tokens、输出 ¥2.8 / 百万 tokens。
3.8 DeepSeek-V4.1-Flash:轻量旗舰推理模型
DeepSeek-V4.1-Flash 以 552B 总参数 MoE 实现越级智能,在多项基准上超越包括 DeepSeek-V4-Pro 在内的主流旗舰模型。模型采用 Causal Encoder-Decoder 非对称架构,输入激活仅 8B、输出激活 16B,并具备原生多模态视觉理解能力;KV Cache 压缩至上一代 HBM 的 1/4、SSD 的 1/8,显著降低长上下文与 Agent 任务成本。模型支持 1M 上下文与 384K 最大输出,兼顾高吞吐、低延迟与性价比。计费口径为输入 ¥1 / 百万 tokens、输出 ¥4 / 百万 tokens。
3.9 Kimi-K3:超大参数开源旗舰
Kimi-K3 拥有 2.8 万亿参数,基于 KDA 混合线性注意力机制(Kimi Delta Attention)与注意力残差技术构建,原生支持视觉理解,并具备 100 万 token 上下文窗口,是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作与推理等前沿场景。计费口径为输入 ¥20 / 百万 tokens、输出 ¥100 / 百万 tokens。另有 kimi-k2.8-preview,综合性能接近 K3,思考效率更高,支持 thinking effort 档位调节。
3.10 Qwen-Audio 系列与其他音频模型
Qwen-Audio-ASR-Flash 全面支持汉语传统七大方言体系(官话/吴/湘/赣/客/闽/粤),适配 20+ 地区口音官话,并针对中文古诗词的韵律与文言表达进行专项优化,语种扩展至 30 个。Qwen-Audio-TTS 面向实时交互场景优化,支持更多小语种和中文方言,增强了 free-style 指令遵循能力与细粒度标签控制能力,可控制情绪、语气、角色、语速、音量等表达方式。此外,CosyVoice-v3.5-Plus 支持跨多语种超自然听感实时语音合成;MiniMax 语音大模型可根据上下文智能预测文本情绪、语调并生成个性化语音。
四、全量模型能力与计费一览(精选对照表)
下表按能力域选取 191 款模型中的代表性产品,整理其规格、计费方式与关键参数,便于选型时横向比较。表中"输入/输出"已将模态图标转写为文字(文=文本、图=图像、音=音频、视=视频),箭头左侧为输入、右侧为输出;对话/文本模型的关键信息为"上下文 / 最大输出",生成/识别类模型为"RPM / 并发"。
| 模型(ID) | 价格 | 输入/输出 | 关键信息 |
|---|---|---|---|
| Qwen3.8-Max(qwen3.8-max) | 输入 ¥12 / 输出 ¥36 每百万 token | 文/图/音 → 文/音 | 上下文 1M;最大输出 131.1K |
| Qwen3.8-Flash(qwen3.8-flash) | 输入 ¥0.8 / 输出 ¥2.7 每百万 token | 文/图/音 → 文 | 上下文 1M;最大输出 131.1K |
| Qwen3.8-Omni-Flash(qwen3.8-omni-flash) | 输入 ¥0.8 / 输出 ¥2.7 每百万 token | 文/图/音 → 文/音 | 上下文 1M;最大输出 131.1K |
| Qwen3.8 开源模型(qwen3.8-2.4t-a95b) | 输入 ¥12 / 输出 ¥36 每百万 token | 文/音 → 文 | 上下文 1M;最大输出 131.1K |
| Wan3.0-Video(wan3.0-video-prime) | ¥0.45–1.8 每秒 | 文/图/音 → 视/音 | RPM 300;并发 5 |
| Qwen-Image-3.0(qwen-image-3.0) | ¥0.02–0.18 每张 | 文 → 图 | RPM 20;并发 10 |
| Qwen-Image-2.1(qwen-image-2.1-pro) | ¥0.25 每张 | 文 → 图 | RPM 20;并发 10 |
| Qwen-Audio-3.1-Realtime(qwen-audio-3.1-realtime) | 输入 ¥5 / 输出 ¥15 每百万 token | 文/音 → 文/音 | 上下文 262.1K;最大输出 16.4K |
| Qwen-Audio-3.1-TTS(qwen-audio-3.1-tts-flash) | 输入 ¥1.5 / 输出 ¥12 每百万 token | 文 → 音 | RPM 180 |
| Qwen-Audio-3.1-ASR(qwen-audio-3.1-asr-flash) | 输入 ¥0.8 / 输出 ¥2.7 每百万 token | 音 → 文 | RPM 600 |
| DeepSeek(deepseek-v4.1-flash) | 输入 ¥1 / 输出 ¥4 每百万 token | 文 → 文 | 上下文 1M;最大输出 393.2K |
| 智谱 GLM-5.3-Flash(ZHIPU/GLM-5.3-Flash) | 输入 ¥2 / 输出 ¥7 每百万 token | 文 → 文 | 上下文 1M;最大输出 131.1K |
| Kimi(kimi-k3) | 输入 ¥20 / 输出 ¥100 每百万 token | 文/图/音 → 文 | 上下文 1M;最大输出 1M |
| MiniMax 文本模型(MiniMax/MiniMax-M3) | 输入 ¥4.2 / 输出 ¥16.8 每百万 token | 文 → 文 | 上下文 1M;最大输出 131.1K |
| Qwen3.7-Plus(qwen3.7-plus) | 输入 ¥1.6–4.8 / 输出 ¥6.4–19.2 每百万 token | 文/图/音 → 文 | 上下文 1M;最大输出 131.1K |
| Qwen3.5-Omni-Plus(qwen3.5-omni-plus) | 输入 ¥7 / 输出 ¥40 每百万 token | 文/图/音 → 文/音 | 上下文 262.1K;最大输出 65.5K |
| Qwen-VL-OCR(qwen-vl-ocr) | 输入 ¥0.3 / 输出 ¥0.5 每百万 token | 文/图 → 文 | 上下文 38.2K;最大输出 8.2K |
| Qwen-Long(qwen-long) | 输入 ¥0.5 / 输出 ¥2 每百万 token | 文 → 文 | 上下文 10M;最大输出 8.2K |
| Qwen-Embedding(qwen3-text-embedding) | ¥0.125 每百万 token | 文 → 文 | 上下文 131.1K |
| Qwen-VL-Embedding(qwen3-vl-embedding) | ¥0.7–1.8 每百万 token | 文/图 → 文 | RPM 2.4K |
| CosyVoice 大模型(cosyvoice-v3.5-plus) | ¥1.5 每万字符 | 文 → 音 | RPM 180 |
| Qwen-MT-Uni(qwen-mt-uni) | ¥20–400 每百万 token | 文 → 文 | 上下文 1M;最大输出 800K |
| PixVerse V6(pixverse-v6-r2v) | ¥0.15–1.36 每秒 | 文/图 → 视 | RPM 300;并发 5 |
| 可灵 AI(kling-v3-turbo-video-generation) | ¥0.8–1 每秒 | 文/图 → 视 | RPM 300;并发 10 |
| Vidu AI 生视频(viduq3-drama_reference2video) | ¥0.875 每秒 | 文/图 → 视 | RPM 300;并发 5 |
| Tripo(Tripo-H3.1) | ¥0.7–4.2 每次 | 文/图 → 视 | RPM 5;并发 10 |
| StepFun 阶跃星辰(stepfun/step-5-preview) | 输入 ¥7 / 输出 ¥20 每百万 token | 文 → 文 | 上下文 1M;最大输出 1M |
| Qwen3-TTS-Flash(qwen3-tts-flash) | ¥0.8 每万字符 | 文 → 音 | RPM 180 |
| Paraformer 语音识别-v2(paraformer-v2) | ¥0.00008 每秒 | 音 → 文 | RPM — |
| 云知声文本模型(unisound/unisound-u2) | 输入 ¥1 / 输出 ¥2 每百万 token | 文 → 文 | 上下文 163.8K;最大输出 65.5K |
完整的 191 款模型清单及实时价格,可在阿里云百炼平台控制台查看:https://www.aliyun.com/product/bailian
五、价格体系与计费规则详解
5.1 文本生成(元/百万 Token)
文本类模型按"输入/输出"每百万 token 计费,并按上下文长度阶梯定价,部分模型还提供隐式缓存命中、显式缓存创建与显式缓存命中的优惠计费口径。代表性价格如下:
- 旗舰档:
qwen3.8-max、qwen3.8-2.4t-a95b输入 12 / 输出 36;qwen3.7-max输入 12 / 输出 36;qwen-mt-uni按模态区分,文本输入 65、文档输入 20、图片输入 32、音频输入 400。 - 均衡档:
qwen3.6-plus输入 ≤256K 时 2 / 12,256K–1M 时 8 / 48;qwen3.5-plus输入 0.8–4 / 输出 4.8–24;qwen-plus非思考模式 0.8 / 2 起,思考模式 0.8 / 8 起。 - 轻量档:
qwen-flash输入 0.15–1.2 / 输出 1.5–12;qwen3.7-flash输入 0.2–1.2 / 输出 0.8–4.8;qwen3.5-flash输入 0.2–1.2 / 输出 2–12。 - 长上下文专项:
qwen-long输入 0.5 / 输出 2,支持最长 1000 万 tokens(约 1500 万字或 1.5 万页文档)的超长上下文对话。 - 翻译专项:
qwen-mt-flash输入 0.7 / 输出 1.95;qwen-mt-lite输入 0.6 / 输出 1.6;qwen-mt-plus输入 1.8 / 输出 5.4。 - 第三方直供:
deepseek-v4.1-flash忙时 2 / 8、闲时 1 / 4;kimi-k3输入 20 / 输出 100;MiniMax/MiniMax-M3输入 4.2 / 输出 16.8;unisound/unisound-u2输入 1 / 输出 2。
此外,深度研究类模型 qwen-deep-research 计费为输入 54 / 输出 163;OCR 类 qwen-vl-ocr 为输入 0.3 / 输出 0.5;界面交互类 gui-plus 为输入 1.5 / 输出 4.5。
5.2 图像生成(元/张)
图像类模型按张计费,部分模型按输出分辨率分档:
qwen-image-2.00.2 元/张,qwen-image-2.0-pro0.5 元/张;qwen-image-2.1-pro0.25 元/张,qwen-image-2.1-turbo0.1 元/张;qwen-image-3.0输出 1K / 2K 均为 0.18 元/张,图片输入 0.02 元/张;qwen-image-3.0-pro输出 1K 为 0.25、2K 为 0.5 元/张;- 万相系列:
wan2.2-t2i-flash0.14、wan2.2-t2i-plus0.2、wan2.7-image0.2、wan2.7-image-pro0.5、wanx-sketch-to-image-lite0.06 元/张; z-image-turbo关闭提示词改写 0.1、开启提示词改写 0.2 元/张;- 第三方:
kling/kling-v3-image-generation0.2 元/张,4K 档 0.4 元/张;Vidu 系列按 1K/2K/4K 分档,最低 0.3125 元/张起。
5.3 视频生成(元/秒)
视频生成分为"仅按输出视频计费""输入视频与输出视频均计费""按输入素材计费"三类口径:
- 仅按输出视频计费:万相系列
wan2.2-i2v-flash480P 0.1、720P 0.2、1080P 0.48;wan2.6-i2v720P 0.6、1080P 1;wan2.7-t2v、wan2.7-i2v720P 0.6、1080P 1;videoretalk0.08;第三方kling/kling-v3-turbo-video-generation720P 0.8、1080P 1;PixVerse V6 系列 0.15–1.36;Vidu 系列 0.0875–3.1875 不等。 - 输入视频与输出视频均计费:
wan2.7-videoedit720P 0.6、1080P 1;wan3.0-video(限时 7 折)480P 0.21、720P 0.42、1080P 0.84;wan3.0-video-prime480P 0.45、720P 0.9、1080P 1.8;MiniMax/MiniMax-H3768P 0.5、2K 0.8。 - 按输入素材计费:
wan2.2-s2v-detect图片 0.004 元/张;MiniMax/MiniMax-H3图片 5 张以内免费,超出按 0.2 元/张计费。
5.4 语音相关
- 文本转语音(元/万字符):
qwen3-tts-flash0.8、qwen3-tts-flash-realtime1、qwen-audio-3.0-tts-flash1、qwen-audio-3.0-tts-plus1.4、cosyvoice-v3.5-flash0.8、cosyvoice-v3.5-plus1.5、cosyvoice-v3-plus2。 - 声音复刻及声音设计(元/次):
qwen-voice-enrollment0.01,MiniMax系列 9.9。 - 语音转文本(元/秒):
qwen3-asr-flash0.00022、qwen3-asr-flash-realtime0.00033、paraformer-v20.00008、paraformer-realtime-v20.00024、fun-asr系列 0.00022–0.00033。 - 语音对话(元/百万 Token):
qwen3.5-omni-flash输入音频 18、输出音频 72、输入文本/图片/视频 2.2、输出文本 13.3;qwen3.5-omni-plus输入音频 53、输出音频 213;qwen3.8-omni-flash输入 0.8、输出 2.7。
5.5 向量化与重排序(元/百万 Token)
qwen3-rerank 0.5、qwen3-vl-rerank 0.5、qwen3.7-text-embedding-flash 0.125、tongyi-embedding-vision-flash 0.15、text-embedding-v3/v4 0.5、gte-rerank-v2 0.8、multimodal-embedding-v1 文本 0.7 / 图片 0.9。
5.6 同声传译(元/百万 Token)
qwen3-livetranslate-flash 输入音频 10 / 输入图片 4 / 输出文本 10 / 输出音频 40;qwen3.5-livetranslate-flash-realtime 输入音频 40 / 输入图片 3.3 / 输出文本 100 / 输出音频 160。
5.7 3D 生成(元/次)
Tripo/Tripo-H3.1 文生 3D(标准版无贴图)0.7 元/次,单图生 3D 1.4 元/次,带高清贴图的超清版最高 4.2 元/次;Tripo/Tripo-P1.0 2.1–4.2 元/次。
5.8 世界模型
happyoyster-1.0-adventure 世界体验(480P)0.2 元/秒,世界创建 0.05 元/次。
5.9 价格结构规律小结
从价格结构可读出几条选型规律:其一,文本模型呈现明显的"旗舰—均衡—轻量"三档梯度,Max 档输入/输出约为 Flash 档的 10–15 倍,但能力上限与长程任务完成度也显著更高;其二,多模态与实时模型通常按 token 计费且单价偏高,适合对融合体验有刚性需求的场景,纯文本场景应优先选用对应文本模型以控制成本;其三,生成类模型(图像、视频、语音)按张/秒/字符计费,并发与 RPM 是规模化生产时必须关注的限流维度,高吞吐业务需提前评估配额与扩容策略。
六、首次调用千问 API 的操作路径
平台提供新人免费额度。完成以下步骤后,即可用 Python、Node.js 或其他语言发起真实请求。如果已在使用 OpenAI SDK,无需重新学习——只需将 base_url 指向平台、替换 API Key,即可复用现有代码。
步骤一:创建账号并获取 API Key。 访问千问 AI 平台(https://platform.qianwenai.com/),使用手机号、账号密码、支付宝扫码等方式登录;随后进入 API Key 页面(https://platform.qianwenai.com/home/api-keys)点击创建,复制以 sk-ws- 开头的 Key。请妥善保管 API Key,不要提交到代码仓库或公开分享。
步骤二:配置 API Key 到环境变量。 建议将 API Key 配置到环境变量,而不是直接写在代码里,以降低泄露风险。macOS / Linux 可执行 export DASHSCOPE_API_KEY="sk-your-api-key-here";Windows PowerShell 可执行 $env:DASHSCOPE_API_KEY = "sk-your-api-key-here"。
步骤三:调用千问 API。 平台兼容 OpenAI SDK。Python 侧可先 pip install openai,再创建 hello_qwen.py,将 base_url 设为 https://maas.qianwenaiapi.com/compatible-mode/v1,以 qwen3.8-max 为 model 发起对话补全请求;Node.js 侧可 npm install openai,创建 hello_qwen.mjs 后以相同 baseURL 调用;亦可直接使用 curl 向 https://maas.qianwenaiapi.com/compatible-mode/v1/chat/completions 发送 POST 请求。Java、Go、PHP、C# 等语言可直接使用 curl 标签页中的 OpenAI 兼容端点,配合各语言 HTTP 客户端调用。
需要说明的是,在模型市场中,推理服务商为千问 AI 平台的模型无需手动开通,获取 API Key 后即可直接调用(部分邀测模型除外);其他推理服务商(如硅基流动)的直供模型,需要先在模型市场开通后才能调用。
七、阿里云大模型相关最新活动
为帮助更多开发者和企业用户更好地使用千问大模型,阿里云持续推出各类优惠活动和资源支持计划。
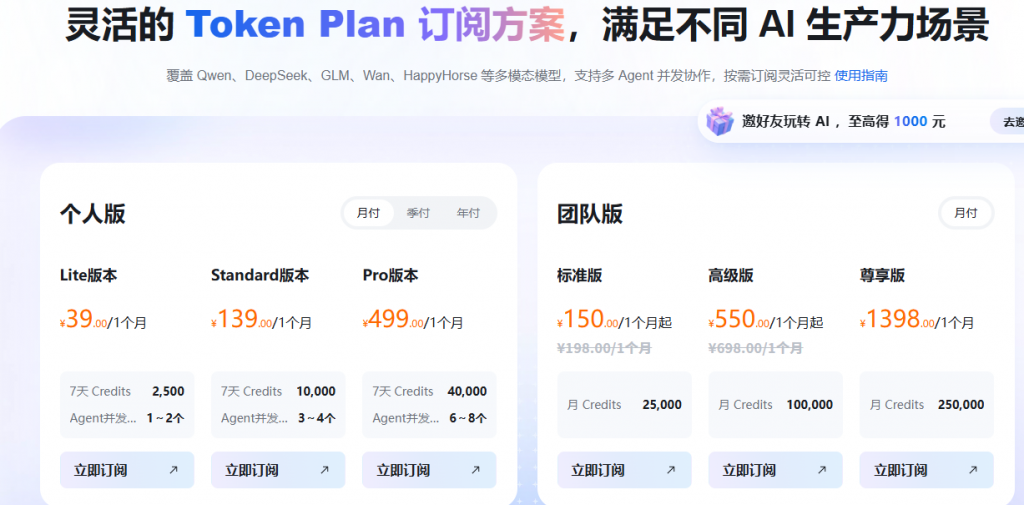
Token Plan 活动是目前备受关注的优惠活动之一。Token Plan 允许用户以预付费方式购买一定数量的 Token 额度,享受比按量付费更优惠的价格,不同规格对应不同折扣力度,用户可根据实际用量需求选择合适的套餐。对用量较大的企业用户而言,Token Plan 能够显著降低 AI 调用成本。详情可访问阿里云百炼 Token Plan 服务页面:https://www.aliyun.com/benefit/scene/tokenplan
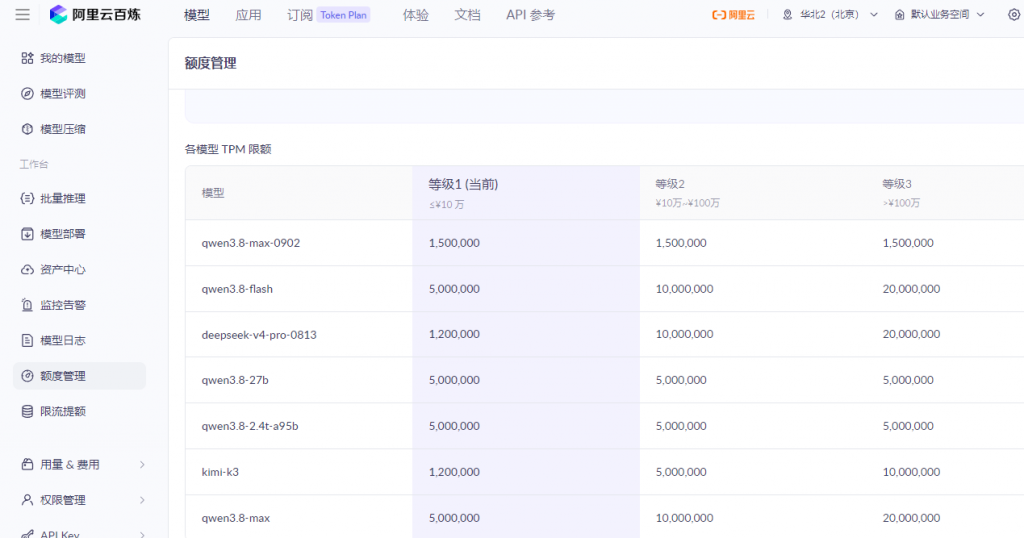
新用户免费体验活动。 首次开通阿里云百炼的用户,系统自动为每个模型发放 100 万 Token 免费额度(输入与输出共用总额度),覆盖 70+ 主流模型,总额度超 7000 万 Token。自开通百炼之日起 90 天内有效,过期后自动失效,不支持补发、延期或重置。该额度仅支持华北 2(北京)地域的模型实时推理调用,不支持 Batch 批量调用、模型调优等场景。新人免费额度介绍:https://help.aliyun.com/zh/model-studio/new-free-quota
模型限时免费活动。 阿里云会不定期推出特定模型的限时免费调用活动,让用户免费体验最新发布的模型能力。这类活动通常在新模型发布初期推出,是第一时间体验新技术的好机会。详情可通过百炼平台了解:https://www.aliyun.com/product/bailian
企业专属优惠。 针对企业级用户,阿里云提供专属的商务咨询和定制化方案。企业用户可根据自身业务需求,获得更灵活的计费方式、更高的调用配额以及更专业的技术支持服务。
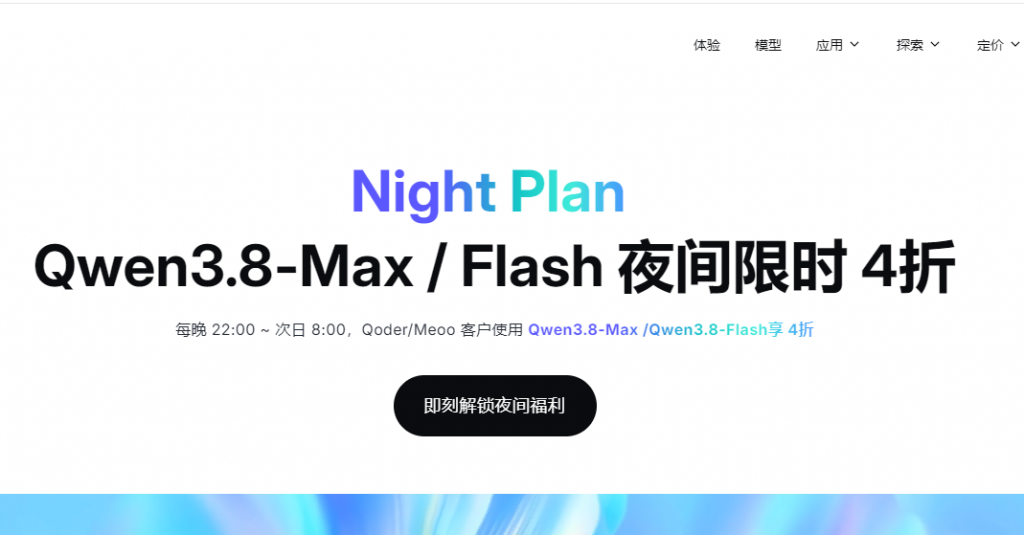
Night Plan 夜间错峰优惠。 每晚 22:00 至次日 08:00(北京时间),Qoder 和秒悟 Meoo 客户可享受大幅折扣。根据 2026 年 8 月的定价信息,qwen3.8-max 夜间时段计费系数可降至 0.01 倍(即按原价 1% 计费);根据 2026 年 7–8 月的活动信息,qwen3.7-max 可享 2 折优惠;qwen3.7-plus、qwen3.7-flash 等模型的夜间错峰折扣权益,具体折扣力度建议以百炼控制台实时展示为准。覆盖产品包括 Qoder 全系及秒悟 Meoo 网页端,Pro Trial 试用用户及付费订阅用户自动生效。活动详情可参考:https://www.aliyun.com/benefit
八、接入与选型建议
针对"如何从 191 款模型中做出合理选择"这一工程问题,可遵循以下决策路径:
- 先定模态,再定规格。 明确任务是否需要图像、音频、视频输入输出,再在对应模态谱系内选择 Max / Plus / Flash 等规格档位。
- 以上下文与最大输出为硬约束。 长文档、长对话任务应优先满足上下文窗口(如 Qwen-Long 的 10M、Kimi 的 1M),避免截断导致信息损失。
- 以延迟与并发为性能约束。 在线交互场景优先 Flash / Realtime 模型并核对 RPM;离线批量生成场景可放宽延迟,争取更高吞吐与更低单价。
- 以合规为部署约束。 数据敏感业务选择私有化或专属资源池方案;弹性互联网业务选择云端 API。
- 以迭代为运维约束。 关注模型版本更新与接口兼容性,建立模型评估与灰度切换机制,避免单点锁定。
小结:千问大模型以 191 款模型、全模态覆盖与灵活的部署形态,构建了一个从能力底座到行业落地的完整体系。其价值不仅在于单点模型的参数规模或基准成绩,更在于通过阿里云百炼这一统一平台,将"选模型、接模型、管模型、用模型"的全链路工程成本显著降低,使 AI 能力得以从头部企业向更广泛的开发者与行业渗透。
在技术持续迭代、生态不断开放的背景下,千问大模型正逐步成为中国大模型产业从追赶到引领进程中的一个具有代表性的坐标。对于正在规划智能化转型的团队而言,理解其模型体系、把握其收费结构、善用其平台活动,是做出理性选型决策的第一步。