对于需要落地AI业务的开发者与企业而言,精准匹配模型能力与业务需求,同时控制推理成本,是AI项目落地的核心环节。阿里云百炼大模型平台凭借全栈多模态模型矩阵,可支撑从简单内容生成到复杂智能体开发的各类业务需求。本文直接梳理千问系列核心技术优势、191款全品类模型的能力边界与定价明细,帮助不同规模的用户快速锁定适配方案,避开选型踩坑,在保障业务效果的前提下最大化优化AI推理投入产出比。千问大模型平台详情:https://www.aliyun.com/product/tongyi

一、千问大模型是什么?
千问(Qwen)大模型是阿里云自主研发的大规模语言模型系列,是阿里巴巴集团在人工智能领域的核心技术成果之一。自发布以来,千问大模型凭借其卓越的性能表现和持续的技术迭代,已成为国内外最受关注的大模型产品之一,广泛应用于自然语言处理、计算机视觉、多模态理解与生成等多个领域。
作为阿里巴巴集团在AI赛道上的战略性产品,千问大模型不仅承载着技术突破的使命,更肩负着推动AI技术普惠化、降低企业智能化转型门槛的重要责任。从最初的文本生成模型到如今覆盖全模态的综合AI平台,千问大模型的发展历程折射出了中国大模型产业从追赶到引领的蜕变之路。
千问大模型的核心优势主要体现在以下几个方面:
第一,强大的基础能力。 千问大模型基于海量高质量数据进行预训练,在语言理解、逻辑推理、知识问答、代码生成等基础任务上表现优异。其参数规模覆盖从数十亿到数千亿不等,能够满足不同场景下的性能与效率需求。在多项国际权威基准测试中,千问大模型均取得了领先的成绩,尤其在中文理解与生成方面具有天然的优势。无论是复杂的学术推理、专业的法律咨询,还是日常的对话交互,千问大模型都能提供准确、流畅且富有深度的回复。
第二,丰富的模态覆盖。 千问大模型已经从最初的纯文本模型,发展为涵盖视觉语言、视觉理解、图片生成、视频生成、全模态交互、语音识别等多种模态的综合模型家族。无论是文本处理、图像分析还是音视频理解,千问系列都能提供强大的支持。这种全模态的覆盖能力使得千问大模型能够应对更加复杂和多样化的业务场景,从简单的文字问答到复杂的视频内容生成,从静态图片理解到动态交互体验,千问大模型家族都能提供对应的解决方案。
第三,灵活的部署方式。 千问大模型支持云端API调用、私有化部署等多种方式,用户可以根据自身业务需求选择合适的接入方案。通过阿里云百炼平台,开发者可以快速集成千问大模型的能力,降低AI应用的开发门槛。对于数据安全要求较高的企业用户,私有化部署方案能够确保数据不出域,满足合规要求;而对于追求快速上线和弹性扩展的互联网应用,云端API调用则提供了最便捷的接入方式。此外,千问大模型还支持模型微调、知识库增强等定制化服务,帮助企业打造专属的AI能力。
第四,持续的技术迭代。 千问大模型团队保持着高频的更新节奏,不断推出性能更强的新版本。从Qwen1.0到Qwen3.8,每一代模型都在前代基础上实现了显著的能力提升。这种快速迭代的节奏不仅体现了团队强大的研发实力,也确保了用户始终能够使用到最前沿的AI技术。每一次版本更新都伴随着基准测试成绩的全面提升,以及在真实应用场景中的显著改善。
第五,开放的生态体系。 千问大模型坚持开源与商业化并行的发展路线,通过开源社区吸引了大量开发者参与贡献和反馈,形成了良性的技术生态。开源模型的发布不仅推动了整个行业的技术进步,也为千问大模型积累了广泛的用户基础和社区影响力。
在适用场景方面,千问大模型广泛服务于智能客服、内容创作、代码辅助、数据分析、教育学习、企业办公、创意生成等众多领域。无论是个人开发者还是企业用户,都能在千问大模型生态中找到适合自己需求的模型产品。从初创团队的快速原型验证,到大型企业的规模化AI应用部署,千问大模型都能提供从模型选择、接入集成到运维支持的全链路服务。
二、阿里云百炼平台可使用大模型汇总(共计191款)
阿里云百炼平台作为阿里巴巴集团面向开发者和企业的一站式大模型服务平台,汇聚了191款不同能力、不同规格的大模型产品。这些模型覆盖了文本生成、多模态理解、图像生成、视频创作、语音交互等多种AI能力,能够满足从轻量级应用到重度生产环境的各类需求。以下将逐一介绍各款模型的核心能力与收费标准。
2.1 热门实例能力与适用场景简介
1、Qwen3.8-Max
模型定位: 旗舰级全能大模型
核心能力:
Qwen3.8-Max是千问系列中参数规模最大的旗舰模型,拥有2.4万亿参数的MoE(混合专家)架构,代表了当前千问大模型家族的最高技术水平。该模型在编程与办公能力方面实现了全面跃升,具备自主编程十数天交付完整项目的能力,这在业界属于极为罕见的长程自主工作能力。
在具体应用场景中,Qwen3.8-Max能够胜任法律、金融、设计等数百种专业任务,一次对话即可端到端交付生产级成果。这意味着用户无需进行多轮反复调试,模型能够在单次交互中完成从需求理解、方案设计到最终交付的完整流程。
该模型还具备原生视觉理解能力,这一能力贯穿规划、执行与验证全流程,支持超长文档与长视频的深度语义解析。在长程任务中,模型能够自主规划与闭环迭代,展现出持续进化的能力特征。
适用场景: 复杂项目开发、专业领域咨询、长文档分析、企业级智能助手
收费标准:
- 输入:¥12/M tokens
- 输出:¥36/M tokens
2、Qwen3.8-Flash
模型定位: 高性能轻量级多模态模型
核心能力:
Qwen3.8-Flash是千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。该模型在设计之初就充分考虑了效率与性能的平衡,旨在为开发者提供一个既强大又经济的模型选择。
模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。这一特性使得Qwen3.8-Flash在处理大规模文本分析、代码审查、长对话管理等场景中具有显著优势。用户无需担心上下文截断问题,可以将完整的项目代码或长篇文档一次性输入模型进行处理。
在编程辅助、智能体协作、图文理解等场景中,Qwen3.8-Flash表现尤为出色。无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。模型还兼容OpenAI与Anthropic主流接口协议,可无缝接入Claude Code、Codex等开发者工具,轻松构建高并发应用与智能工作流。
凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash是开发者和企业在AI应用中兼顾效果与效率的理想选择。
适用场景: 编程辅助、智能体开发、图文理解、高并发应用、长文档处理
收费标准:
- 输入:¥0.8/M tokens
- 输出:¥2.7/M tokens
3、Qwen3.8开源模型 qwen3.8-2.4t-a95b
模型定位: 开源旗舰模型
核心能力:
Qwen3.8-2.4T-A95B是千问最新旗舰系列的开源版本,于2026年8月正式发布。该模型采用稀疏MoE架构,总参数达到2.4万亿,每步激活约950亿参数,配合混合注意力机制,支持100万Token上下文。
作为开源模型,Qwen3.8-2.4T-A95B在核心基准测试中取得了令人瞩目的成绩:GPQA Diamond 92.6、PaperBench 93.0、OSWorld 86.1、BabyVision 82.0,CodeArena全球第4。这些成绩表明,该开源模型在推理能力、学术理解、操作系统交互、视觉理解以及代码能力等方面均达到了世界顶尖水平。
开源版本的发布为研究社区和企业用户提供了更多可能性。研究者可以基于该模型进行进一步的微调和定制开发,企业则可以在保障数据安全的前提下进行私有化部署。
适用场景: 学术研究、私有化部署、模型微调、企业定制开发
收费标准:
- 输入:¥12/M tokens
- 输出:¥36/M tokens
4、Wan3.0-Video
模型定位: 高速视频生成模型
核心能力:
Wan3.0-Video-Prime是万相3.0的高速版视频生成模型,能力对齐Wan3.0-Video标准版。该模型支持四模态全能参考,最长可生成30秒视频,带来沉浸式视听体验的同时端到端速度显著提升。
在视频生成领域,Wan3.0-Video代表了当前国内视频生成模型的最高水平之一。四模态全能参考意味着模型可以同时参考文本描述、参考图片、参考视频以及音频信息来生成目标视频,极大地提升了创作的可控性和灵活性。
30秒的视频生成时长在当前市场中属于领先水平,足以满足短视频创作、广告素材制作、产品展示等多种商业需求。端到端速度的显著提升则意味着用户可以在更短的时间内获得生成结果,提升了创作效率。
适用场景: 短视频创作、广告制作、产品展示、创意内容生成
收费标准:
- ¥0.45-1.8/秒(根据视频分辨率和时长不同有所浮动)
5、智谱GLM系列文本模型
模型定位: 原生多模态轻量旗舰
核心能力:
GLM-5.3-Flash是GLM-5系列首个原生多模态模型,以极致低成本架构实现超越GLM-5.2的更强智能。该模型采用320B总参/18B激活的稀疏+线性注意力混合架构,注意力计算量与KV缓存分别降低3.01倍和4.44倍,在保持高性能的同时大幅降低了推理成本。
GLM-5.3-Flash的视觉能力原生融入Coding循环,可主动观察界面、渲染结果与交互反馈,跨代码、浏览器与图形界面协同完成任务。这一特性使得模型在Web开发、UI设计、自动化测试等场景中具有独特优势。
同时,该模型拓展至Office、金融研究及专业文档场景,能自主拆解目标、调用工具并优化输出,交付PPTX、PDF、DOCX、XLSX等高质量成品。这种端到端的文档生成能力为企业办公自动化提供了强大的技术支撑。
适用场景: Web开发、UI设计、办公自动化、金融研究、专业文档生成
收费标准:
- 输入:¥0.8/M tokens
- 输出:¥2.8/M tokens
6、DeepSeek系列模型
模型定位: 轻量旗舰推理模型
核心能力:
DeepSeek-V4.1-Flash是DeepSeek全新架构系列中的轻量旗舰模型,以552B总参数MoE实现越级智能,在多项基准上超越包括DeepSeek-V4-Pro在内的主流旗舰模型。该模型采用Causal Encoder-Decoder非对称架构,这一创新架构设计使得模型在保持轻量级的同时具备了强大的推理和生成能力。
DeepSeek系列模型以其出色的推理能力和极具竞争力的定价策略在市场上获得了广泛关注。V4.1-Flash作为该系列的最新成员,在数学推理、代码生成、逻辑分析等方面表现突出,特别适合需要高精度推理的应用场景。
适用场景: 数学推理、代码生成、逻辑分析、学术研究
2.2 完整191款大模型能力及收费标准简介
1、Qwen3.8-Max
2.4万亿参数MoE旗舰,编程与办公能力全面跃升,可自主编程十数天交付完整项目。胜任法律、金融、设计等数百种专业任务,一次对话端到端交付生产级成果。原生视觉理解贯穿规划、执行与验证全流程,支持超长文档与长视频的深度语义解析。长程任务中自主规划与闭环迭代,持续进化。
输入:¥12/M tokens
输出:¥36/M tokens
2、Qwen3.8-Flash
Qwen3.8-Flash 是千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。同时兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 是开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
输入:¥0.8/M tokens
输出:¥2.7/M tokens
3、Qwen3.8开源模型 qwen3.8-2.4t-a95b
Qwen3.8-2.4T-A95B 是千问最新旗舰系列的开源版本,2026 年 8 月发布。采用稀疏 MoE 架构,总参数 2.4 万亿,每步激活约 950 亿,配合混合注意力机制,支持 100 万 Token 上下文。核心基准:GPQA Diamond 92.6、PaperBench 93.0、OSWorld 86.1、BabyVision 82.0,CodeArena 全球第 4。
输入:¥12/M tokens
输出:¥36/M tokens
4、Wan3.0-Video
Wan3.0-Video-Prime 是万相3.0 的高速版视频生成模型,能力对齐 Wan3.0-Video 标准版,支持四模态全能参考,最长可生成30秒视频,带来沉浸式视听体验的同时端到端速度显著提升。
¥0.45-1.8每秒
5、智谱GLM系列文本模型
ZHIPU/GLM-5.3-Flash
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型,以极致低成本架构实现超越 GLM-5.2 的更强智能。采用 320B 总参 / 18B 激活的稀疏+线性注意力混合架构,注意力计算量与 KV 缓存分别降低 3.01 倍和 4.44 倍。视觉能力原生融入 Coding 循环,可主动观察界面、渲染结果与交互反馈,跨代码、浏览器与图形界面协同完成任务。同时拓展至 Office、金融研究及专业文档场景,能自主拆解目标、调用工具并优化输出,交付 PPTX、PDF、DOCX、XLSX 等高质量成品。
输入:¥0.8/M tokens
输出:¥2.8/M tokens
6、DeepSeek
DeepSeek-V4.1-Flash 是 DeepSeek 全新架构系列中的轻量旗舰模型,以 552B 总参数 MoE 实现越级智能,在多项基准上超越包括 DeepSeek-V4-Pro 在内的主流旗舰模型。采用 Causal Encoder-Decoder 非对称架构,输入激活仅 8B、输出激活 16B,并具备原生多模态视觉理解能力。KV Cache 压缩至上一代 HBM 的 1/4、SSD 的 1/8,显著降低长上下文与 Agent 任务成本。支持 1M 上下文与 384K 最大输出,兼顾高吞吐、低延迟与极致性价比。
输入:¥1/M tokens
输出:¥4/M tokens
7、Kimi(kimi/kimi-k2.8-preview)
kimi/kimi-k2.8-preview,综合性能接近 K3,思考(thinking)效率更高;支持 thinking effort 档位调节(与 K3 的思考等级一致);支持 1M 超长上下文
输入:¥6.5/M tokens
输出:¥27/M tokens
8、Kimi(kimi-k3)
Kimi-K3 是 Kimi 迄今能力最强的旗舰模型,拥有 2.8 万亿参数,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
输入:¥20/M tokens
输出:¥100/M tokens
9、Qwen-Image-3.0
指令理解清晰:支持最大 4.5k token 输入,复杂图文指令一次生成到位。 文字渲染稳定:10px 小字、12 国语言、20+ 字体清晰可辨,信息图和界面直接可用。 批量产出趁手:海报、网页、界面等日常任务可批量生成,成本更优,适合持续创作。 Qwen-Image-3.0 Standard 不只在追求生成效果,更在追求日常创作里的顺手与省心——让图像生成成为可持续的内容生产力。
¥0.02-0.18每张
10、MiniMax视频模型
MiniMax H3 是一个通用型全模态生成系统。它能够统一理解由文本、图像、视频和音频构成的多模态上下文,并可生成最高 2K 分辨率、最长 15 秒、带有原生立体声音频的视频。得益于以任务泛化为导向的系统设计,H3 在预训练阶段便已具备广泛的多模态上下文理解与生成能力,因此能够出色地遵循复杂的多模态指令。
¥0.2-0.8每秒
11、Qwen-Audio-ASR-Flash
qwen-audio-3.0-asr-flash
百聆2026年6月更新的大模型ASR版本,全面支持汉语传统七大方言体系(官话/吴/湘/赣/客/闽/粤),并适配 20+ 地区口音官话。针对中文古诗词的韵律、节奏与文言表达特点进行专项优化,提升对古诗词内容的识别准确率,适用于文化传承、教育讲解、有声读物等场景。优化标点预测与文本归一化能力,使输出文本更符合书面表达习惯,数字、日期、金额等信息自动转换为标准格式,增强内容的可读性与专业性。同时语种扩展至英语、日语、韩语、越南语、泰语、印尼语、马来语、菲律宾语、印地语、阿拉伯语、法语、德语、西班牙语、葡萄牙语、俄语、意大利语、荷兰语、瑞典语、丹麦语、芬兰语、挪威语、希腊语、波兰语、捷克语、匈牙利语、罗马尼亚、保加利亚语、克罗地亚语、斯洛伐克语等,共计30个语种。支持context上下文能力,可转写5分钟以内的音频。
¥0.00022每秒
12、Qwen-Audio-ASR-Flash-Filetrans
qwen-audio-3.0-asr-flash-filetrans是专为非实时、整段音视频文件设计的高性能转写模型。它不仅集成了 Context(上下文增强)能力,还强化了垂直行业热词的识别精度,非常适合短视频字幕、客服质检和金融双录场景。
¥0.00022每秒
13、Qwen-Audio-ASR-Flash-Streaming
qwen-audio-3.0-asr-flash-streaming是通义实验室专为低延迟、高并发实时交互场景打造的旗舰级语音识别模型。它不仅能实现“边说边出字”的极致流畅体验,并深度集成了 Context(上下文增强)能力,还针对垂直行业专业词汇进行了深度强化训练,是构建实时会议同传、智能客服坐席辅助、语音助手等应用的首选。
¥0.00033每秒
14、Qwen-Audio-TTS
qwen-audio-3.0-tts-flash
Qwen-Audio-3.0-TTS-Flash是面向实时交互场景优化的高性能语音合成大模型。相比前一版本,模型支持更多小语种和中文方言,提升了方言发音的正宗程度,并增强了 free-style 指令遵循能力和细粒度标签控制能力,可更灵活地控制情绪、语气、角色、语速、音量等表达方式。同时,模型在噪声、混响等复杂声学条件下具备更强鲁棒性,提升了音质、清晰度和整体表现力。Flash 版本重点优化实时合成体验,适用于语音助手、实时对话、智能客服等低延迟交互场景。
¥1每万字符
15、Qwen-Audio-Realtime-Flash
千问实时语音对话大模型3.0 是一款登顶全球权威评测的下一代实时双工语音大模型,它在全球权威第三方评测平台 Artificial Analysis Speech-to-Speech子项中取得综合排名第一。千问实时语音对话大模型3.0兼顾了模型智商与双工对话节奏,在保持流畅、自然的实时交互体验的同时,语音推理能力不打折扣;并通过并行推理和全向流式等工程优化,将端到端响应时延控制在低水平,实现"又快又聪明"的对话体验。极速版更注重极致的响应速度
输入:¥3/M tokens
输出:¥30/M tokens
16、Qwen-Audio-Realtime-Plus
qwen-audio-3.0-realtime-plus
千问实时语音大模型 是一款登顶全球权威评测的下一代实时双工语音大模型,它在全球权威第三方评测平台 Artificial Analysis Speech-to-Speech子项中取得综合排名第一。千问实时语音大模型 兼顾了模型智商与双工对话节奏,在保持流畅、自然的实时交互体验的同时,语音推理能力不打折扣;并通过并行推理和全向流式等工程优化,将端到端响应时延控制在低水平,实现"又快又聪明"的对话体验。标准版更注重高质量的回复结果。
输入:¥5/M tokens
输出:¥40/M tokens
17、Qwen3.7-Plus
Qwen3.7系列中高性价比Plus模型,在强大文本能力的基础上全面升级了视觉-语言能力,同时保持了在编码、工具使用和生产力工作流方面的完整智能体能力。其核心特色为多模态交互混合智能体能力,能够感知真实世界场景、读取屏幕并操作 GUI、基于视觉参考生成代码、端到端导航移动应用。
输入:¥1.6-4.8/M tokens
输出:¥6.4-19.2/M tokens
18、GLM-5.2-Fast
GLM-5.2-Fast-Preview 是智谱 AI 旗舰模型 GLM-5.2 的高速版本,支持 1M 超长上下文,模型能力对齐 GLM-5.2 标准版,具备逻辑推理、长文本理解与代码生成能力。通过推理加速优化,输出 TPS 可达 GLM-5.2 标准版的 1.5~2 倍,显著提升输出速度,适用于实时对话、Agent 多轮调用、流式代码生成等对输出速度敏感的场景。
输入:¥16/M tokens
输出:¥56/M tokens
19、Qwen-Image-2.0-Pro
Qwen-Image-2.0系列满血版模型,实现了图片生成和图片编辑的融合;具备更专业的文字渲染1k token指令支持能力、更细腻的真实质感,细腻刻画写实场景、更强的语义遵循能力。满血版具备2.0系列最强的文字渲染能力和真实质感。
¥0.5每张2
20、Wan-I2V
万相2.7-图生视频,演绎能力全面升级,文戏情感细腻自然,动作戏激烈拳拳到肉,搭配更富有戏剧性和节奏感的镜头切换,实现更强表演能力。
¥0.6-1每秒
21、Wan-T2V
Wan2.7-T2V,演绎能力全面升级,文戏情感细腻自然,动作戏激烈拳拳到肉,搭配更富有戏剧性和节奏感的镜头切换,实现更强表演能力。
¥0.6-1每秒
22、Wan-VideoEdit
Wan2.7-VideoEdit,自然语言指令编辑视频,支持局部或全局编辑,可参考图像替换视频元素,支持复刻视频动作、特效、运镜等动态过程。
¥0.6-1每秒
23、Wan-Image
万相2.7-图像生成与编辑旗舰版模型,支持文生图、文生组图、图生组图、图像编辑、多图参考生成、交互式编辑,在文字渲染、主体一致性、复杂指令遵循上都有更强表现。
¥0.5每张
24、Qwen3.7-Max
Qwen3.7系列中规模最大、综合能力最强的Max模型,当前开放纯文本模型能力供体验。Qwen3.7是面向智能体时代的新一代旗舰模型,核心优势在于智能体能力的广度与深度:在编程、办公与生产力、长周期自主执行方面均能出色胜任各项任务。
输入:¥12/M tokens
输出:¥36/M tokens
25、Qwen3.7-Flash
Qwen3.7原生视觉语言系列Flash模型,相较3.6-Flash全面提升多模态理解与Agent执行能力。重点强化多模态基础能力、万物识别能力更强,真实世界感知与空间智能进一步提升,Search Agent、CI Agent等多模态Agent场景能力显著升级、端到端任务执行更稳定,多模态Coding能力优化、vibe coding 体验更加流畅。
输入:¥0.2-1.2/M tokens
输出:¥0.8-4.8/M tokens
26、Qwen3.6-Max
Qwen3.6系列中规模最大、综合能力最强的Max模型Preview版本,当前开放纯文本模型能力供体验。相较于此前发布的Qwen3-Max和Qwen3.6-Plus,本模型在vibe coding能力上进一步提升、coding agent执行更加高效、前端编程开发能力显著提升;长尾知识能力进一步升级。
输入:¥9-15/M tokens
输出:¥54-90/M tokens
27、Qwen3.6-Plus
Qwen3.6原生视觉语言系列Plus模型,展现出与当前顶尖前沿模型相媲美的卓越性能,模型效果相较3.5系列显著提升。模型在Agentic coding、前端编程、Vibe coding等代码能力、多模态万物识别、OCR、物体定位等能力上显著增强。
输入:¥2-8/M tokens
输出:¥12-48/M tokens
28、Qwen3.5-Plus
Qwen3.5原生视觉语言系列Plus模型,基于混合架构设计,融合了线性注意力机制与稀疏混合专家模型,实现了更高的推理效率。在多项任务评测中,3.5系列均展现出与当前顶尖前沿模型相媲美的卓越性能,模型效果在纯文本与多模态方面相较3系列均实现飞跃式进步。
输入:¥0.8-4/M tokens
输出:¥4.8-24/M tokens
29、Qwen3.5-OCR
Qwen3.5系列OCR模型,在文档解析、文本定位、关键信息提取等方面全面升级,在真实场景的业务卡证(如国内国际身份证、驾驶证等业务场景中)抽取上效果显著提升。
输入:¥0.5/M tokens
输出:¥2/M tokens
30、Qwen3.5-Omni-Plus
Qwen3.5-Omni是Qwen最新一代全模态大模型,支持文本,图片,音频,音视频理解与交互。作为 Qwen3-Omni 的全面进化版本, 支持超过 10 小时的音频理解及超过 400 秒的 720P(1 FPS)音视频理解与对话,并进一步拓展语言范围,支持60+种语言音频输入,30+语言语音输出,并且具备强大的结构化音视频理解能力,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态理解与交互体验。
输入:¥7/M tokens
输出:¥40/M tokens
31、Qwen3.5-Omni-Plus-Realtime
Qwen3.5-Omni是Qwen最新一代全模态大模型,支持文本,图片,音频,音视频理解与交互。作为 Qwen3-Omni 的全面进化版本,支持60+种语言音频输入,30+语言语音输出以及可控语音对话,WebSearch和复杂FunctionCall的调用,并且具备智能语义打断的交互能力,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态交互体验。
输入:¥10/M tokens
输出:¥60/M tokens
32、Qwen3.5-Omni-Flash
Qwen3.5-Omni是Qwen最新一代全模态大模型,支持文本,图片,音频,音视频理解与交互。作为 Qwen3-Omni 的全面进化版本, 支持超过 10 小时的音频理解及超过 400 秒的 720P(1 FPS)音视频理解与对话,并进一步拓展语言范围,支持60+种语言音频输入,30+语言语音输出,并且具备强大的结构化音视频理解能力,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态理解与交互体验。
输入:¥2.2/M tokens
输出:¥13.3/M tokens
33、Qwen3.5-Omni-Flash-Realtime
Qwen3.5-Omni是Qwen最新一代全模态大模型,支持文本,图片,音频,音视频理解与交互。作为 Qwen3-Omni 的全面进化版本,支持60+种语言音频输入,30+语言语音输出以及可控语音对话,WebSearch和复杂FunctionCall的调用,并且具备智能语义打断的交互能力,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态交互体验。
输入:¥3.3/M tokens
输出:¥20/M tokens
34、CosyVoice大模型
CosyVoice-v3.5-Plus是通义实验室CosyVoice系列的超高表现力语音合成大模型。对声音克隆和声音设计的语音合成效果进行全面升级,确保说话人高相似度的前提下,支持free-style指令控制,合成风格丰富多样。较之前版本大幅减少首包延迟,同时提高发音准确率,改善韵律和音质。支持跨多语种(中、英、德、法、俄、日、韩、葡、泰、印尼、越南)超自然听感实时语音合成。
¥1.5每万字符
35、voice-enrollment
大模型声音复刻服务依托先进的大模型技术进行特征提取,无需训练过程就可以完成声音的复刻。仅需提供极短的音频,即可迅速生成高度相似且听感自然的定制声音。 大模型声音设计使用FunAudioGen-VD模型,支持通过文本Prompt描述,创造声音。无需受限任何音频质量,根据目标场景对音色、语气、语调、语速、情绪等各方面表现力的需求描述,即可生成高质量语音。高度还原专业配音演员的演出水准。
¥0每次
36、GLM
GLM-5.3 是智谱最新旗舰大语言模型,编程与智能体能力全面进阶,达开源模型 SOTA 水平,内部编程基准较上代提升 50%,可端到端交付生产级成果。涌现网络安全能力,漏洞发现基准 CyberGym 创当前最佳。支持 1M 上下文、128K 输出与三档深度思考,胜任长程复杂任务。
输入:¥8/M tokens
输出:¥28/M tokens
37、qwen3.5-flash
Qwen3.5原生视觉语言系列Flash模型,基于混合架构设计,融合了线性注意力机制与稀疏混合专家模型,实现了更高的推理效率。模型效果在纯文本与多模态方面相较3系列均实现飞跃式进步;响应速度快,兼具推理速度和性能。
输入:¥0.2-1.2/M tokens
输出:¥2-12/M tokens
38、Vanchin DeepSeek
DeepSeek-V4系列是强大的混合专家(MoE)语言模型,包含DeepSeek-V4-Pro(1.6T总参数,49B激活参数)。支持高达100万(1M)token的上下文长度,是在超过32T高质量多样化token上预训练的开源模型。
输入:¥9/M tokens
输出:¥27/M tokens
39、Qwen3-Max
千问3系列Max模型,相较preview版本在智能体编程与工具调用方向进行了专项升级。本次发布的正式版模型达到领域SOTA水平,适配场景更加复杂的智能体需求。
输入:¥2.5-7/M tokens
输出:¥10-28/M tokens
40、Fun-ASR实时语音识别
fun-asr-flash-8k-realtime是通义百聆推出的新一代轻量级实时语音识别模型,依托自研的先进语音技术架构,具备强大的上下文理解能力。专为中文电话客服场景设计:覆盖多地区方言口音,在低采样率、低信噪比环境下实现低延迟、高准确率的流式转写,满足高效部署需求。
¥0.00022每秒
41、Qwen-Image-2.0
Qwen-Image-2.0系列加速版模型,实现了图片生成和图片编辑的融合;具备更专业的文字渲染1k token指令支持能力、更细腻的真实质感,细腻刻画写实场景、更强的语义遵循能力。加速版有效实现了模型效果和性能的最佳平衡。
¥0.2每张
42、Qwen3.6开源模型
Qwen3.6系列27B原生视觉语言Dense模型,模型效果相较3.5-27B重点提升了Agentic coding能力、模型STEM与推理能力进一步增强;视觉模态方面在空间智能、物体定位与检测能力上显著增强,视频理解、文档OCR及视觉Agent能力稳步提升。
输入:¥3/M tokens
输出:¥18/M tokens
43、SiliconFlow DeepSeek
DeepSeek-V3.1-Terminus 是由深度求索(DeepSeek)发布的 V3.1 模型的更新版本,定位为混合智能体大语言模型。此次更新在保持模型原有能力的基础上,专注于修复用户反馈的问题并提升稳定性。它显著改善了语言一致性,减少了中英文混用和异常字符的出现。模型集成了“思考模式”(Thinking Mode)和“非思考模式”(Non-thinking Mode),用户可通过聊天模板灵活切换以适应不同任务。作为一个重要的优化,V3.1-Terminus 增强了代码智能体(Code Agent)和搜索智能体(Search Agent)的性能,使其在工具调用和执行多步复杂任务方面更加可靠
输入:¥4/M tokens
输出:¥12/M tokens
44、Qwen3.6-Flash
Qwen3.6原生视觉语言系列Flash模型,模型效果相较3.5-Flash显著提升。本模型重点提升agentic coding能力(在多项代码智能体基准上大幅超越前代)、数学推理和代码推理能力;视觉方面在空间智能能力上显著增强,物体定位与目标检测提升尤为突出。
输入:¥1.2-4.8/M tokens
输出:¥7.2-28.8/M tokens
45、Fun-ASR语音识别
全面支持汉语传统七大方言体系(官话/吴/湘/赣/客/闽/粤),并适配 20+ 地区口音官话。针对中文古诗词的韵律、节奏与文言表达特点进行专项优化,提升对古诗词内容的识别准确率,适用于文化传承、教育讲解、有声读物等场景。优化标点预测与文本归一化能力,使输出文本更符合书面表达习惯,数字、日期、金额等信息自动转换为标准格式,增强内容的可读性与专业性。同时语种扩展至英语、日语、韩语、越南语、泰语、印尼语、马来语、菲律宾语、印地语、阿拉伯语、法语、德语、西班牙语、葡萄牙语、俄语、意大利语、荷兰语、瑞典语、丹麦语、芬兰语、挪威语、希腊语、波兰语、捷克语、匈牙利语、罗马尼亚、保加利亚语、克罗地亚语、斯洛伐克语等,共计30个语种。此版本等同于2025年11月7日的快照版本。
¥0.00022每秒
46、Fun-ASR-Flash
全面支持汉语传统七大方言体系(官话/吴/湘/赣/客/闽/粤),并适配 20+ 地区口音官话。针对中文古诗词的韵律、节奏与文言表达特点进行专项优化,提升对古诗词内容的识别准确率,适用于文化传承、教育讲解、有声读物等场景。优化标点预测与文本归一化能力,使输出文本更符合书面表达习惯,数字、日期、金额等信息自动转换为标准格式,增强内容的可读性与专业性。同时语种扩展至英语、日语、韩语、越南语、泰语、印尼语、马来语、菲律宾语、印地语、阿拉伯语、法语、德语、西班牙语、葡萄牙语、俄语、意大利语、荷兰语、瑞典语、丹麦语、芬兰语、挪威语、希腊语、波兰语、捷克语、匈牙利语、罗马尼亚、保加利亚语、克罗地亚语、斯洛伐克语等,共计30个语种。支持context上下文能力,可转写5分钟以内的音频。
¥0.00022每秒
47、Qwen3.5-LiveTranslate-Flash-Realtime
Qwen3.5-LiveTranslate-Flash的实时版本,一款高精度、高响应、高鲁棒性的多语言实时音视频同传大模型。依托Qwen3.5-Omni强大的基座能力、海量多模态数据、跨语言跨模态对齐和视觉增强等技术,通义千问3.5-LiveTranslate-Flash 实现了离线和实时两种音视频翻译能力,能听懂60种语言,会说29种语言。
输入:¥3.3/M tokens
输出:¥100/M tokens
48、Qwen-VL-Embedding
基于Qwen3-VL底座训练的统一多模态向量模型,支持文本、图片、视频单模态/混合模态输入,输出统一表征向量,适用于跨模态检索、图搜、视频检索、图像聚类、复杂多模态信息检索、打标等场景
¥0.7-1.8/M tokens
49、Qwen3-ASR-Flash-Realtime
千问3-ASR-Flash的实时版,一款基于大语言模型的高精度、高智能、高鲁棒性的多语种语音识别模型。依托强大的基座模型、海量的文本与多模态数据、千万小时音频数据,通义千问3-ASR-Flash实现了高精度的语音识别功能,能够自动判断语种并准确识别多个语种的语音,在复杂的音频环境下能够保证精确转录。
¥0.00033每秒
50、Qwen-Image-Edit-Max
千问图像编辑模型Max系列,提供更稳定、更丰富的编辑能力:提升工业设计与几何推理能力;提升角色一致性;减轻偏移问题;集成Lora能力,可以进行更多功能的图像编辑。
¥0.5每张
60、Qwen-Image-Plus
千问系列图像生成模型,参数规模200亿。具备卓越的文本渲染能力,在复杂文本渲染、各类生成与编辑任务中表现出色,在多个公开基准测试中获得SOTA,模型性能大幅提升。
¥0.2每张
61、Wan-R2V
万相2.7-参考生视频,更加稳定的角色、道具与场景参考,支持最大5个图/视频混合参考,支持音频音色参考,搭配基础能力升级实现更强表演能力。该版本为2026年6月12日快照。
¥0.6-1每秒
62、Qwen-Image-Max
千问图像生成模型Max系列,在各类生成任务中表现出色,相较Plus系列大幅度降低生成图片的AI感,提升图像真实性;具备更真实的人物质感、更细腻的自然纹理、更美观的文字渲染。
¥0.5每张
63、Qwen-Image-Edit-Plus
千问系列图像编辑Plus模型,相较10月30日快照提升角色一致性、工业设计能力、几何推理能力;同时集成例如打光等Lora能力、减轻偏移问题。此版本为2025年12月15日快照。
¥0.2每张
64、Qwen-VL-OCR
千问VL-OCR(qwen-vl-ocr),即基于Qwen-VL训练的OCR识别大模型。通过统一模型的方式聚合多种图文识别、解析、处理类任务,提供强大的图文识别能力。
输入:¥0.3/M tokens
输出:¥0.5/M tokens
65、Qwen-MT-Lite
基于Qwen3全面升级的基础级文本翻译大模型,支持32个语种互译,模型性能和翻译效果全面升级,并提供更稳定的术语定制、格式还原度、领域提示能力,让译文更精准、自然。
输入:¥0.6/M tokens
输出:¥1.6/M tokens
66、Qwen3-ASR-Flash-Filetrans
千问3-ASR-Flash的大文件转录版本,千问3-ASR-Flash是一款基于大语言模型的高精度、高智能、高鲁棒性的多语种语音识别模型。依托强大的基座模型、海量的文本与多模态数据、千万小时音频数据,千问3-ASR-Flash实现了高精度的语音识别功能,能够自动判断语种并准确识别多个语种的语音,在复杂的音频环境下能够保证精确转录。
¥0.00022每秒
67、Qwen-MT-Flash
基于Qwen3全面升级的轻量级文本翻译大模型
输入:¥0.7/M tokens
输出:¥1.95/M tokens
68、qwen-deep-research
千问深入研究是一款面向复杂研究任务的高级智能体系统,具备多轮推理与全局规划能力,能够运用互联网搜索等多种工具,对任务进行精细化拆解,开展推理与分析,最终为用户生成可溯源、逻辑严谨的研究型报告。
输入:¥54/M tokens
输出:¥163/M tokens
69、Qwen-MT-Image
专注做图片翻译的模型服务,能将中、英、日等55个语言的图片翻译到指定的语言,精准还原图片排版和内容信息,支持术语定义、敏感词过滤、商品主体检测等自定义功能,提供灵活、准确、高效的图像本地化服务。
¥0.004每张60
70、Qwen-MT-Plus
基于Qwen3全面升级的旗舰级翻译大模型,支持92个语种互译,模型性能和翻译效果全面升级,并提供更稳定的术语定制、格式还原度、领域提示能力,让译文更精准、自然。
输入:¥1.8/M tokens
输出:¥5.4/M tokens
71、Qwen-MT-Turbo
基于Qwen3全面升级的轻量级文本翻译大模型,支持92个语种互译,模型性能和翻译效果全面升级,提供更稳定的术语定制、格式还原度、领域提示能力,让译文更精准、自然。
输入:¥0.7/M tokens
输出:¥1.95/M tokens
72、MiMo文本模型
MiMo-V2.5-Pro 是小米发布的最新旗舰模型。与前代模型相比,它在通用智能体能力、复杂软件工程以及长程任务等方面都有显著提升,在 ClawEval、GDPVal 和 SWE-bench Pro 等基准测试中均位列前茅。它能够独立且完全自主地完成需要人类专家耗时数天甚至数周的专业任务,涉及上千次工具调用。其高达 100 万 token 的上下文长度,非常适合集成到各种智能体框架中使用。
输入:¥7/M tokens
输出:¥21/M tokens
73、Qwen3-Coder-Plus
基于Qwen3的代码生成模型,具有强大的Coding Agent能力,擅长工具调用和环境交互,能够实现自主编程、代码能力卓越的同时兼具通用能力。
输入:¥4-20/M tokens
输出:¥16-200/M tokens
74、Qwen3-ASR-Flash
千问3-ASR-Flash是一款基于大语言模型的高精度、高智能、高鲁棒性的多语种语音识别模型。依托强大的基座模型、海量的文本与多模态数据、千万小时音频数据,千问3-ASR-Flash实现了高精度的语音识别功能,能够自动判断语种并准确识别多个语种的语音,在复杂的音频环境下能够保证精确转录。
¥0.00022每秒
75、Qwen3-Coder-Flash
基于Qwen3的代码生成模型,继承Qwen3-Coder-Plus的coding agent能力,支持多轮工具交互,重点优化仓库级别理解能力并增加工具调用稳定性。
输入:¥1-5/M tokens
输出:¥4-25/M tokens
76、Qwen3-Coder-30B-A3B-Instruct
基于Qwen3的代码生成模型,继承Qwen3-Coder-480B-A35B-Instruct的coding agent能力,代码能力达到同尺寸规模模型SOTA。
输入:¥1.5-7.5/M tokens
输出:¥6-37.5/M tokens
77、Qwen3-Coder-480B-A35B-Instruct
基于Qwen3的代码生成模型,具有强大的Coding Agent能力,代码能力达到开源模型 SOTA。
输入:¥3-15/M tokens
输出:¥3-60/M tokens
78、Qwen-Flash-Character
千问系列多语言角色扮演模型,本模型是动态更新版本,模型更新会提前通知,适合拟人化的角色扮演,同时优化了限定人设指令遵循、话题推进、倾听共情等能力,支持个性化角色的深度还原。
输入:¥0.25/M tokens
输出:¥1.5/M tokens
79、Qwen3.5开源模型
Qwen3.5系列27B原生视觉语言Dense模型,融合了线性注意力机制;响应速度快,兼具推理速度和性能。该模型的综合能力接近于Qwen3.5-122B-A10B。
输入:¥0.6-1.8/M tokens
输出:¥4.8-14.4/M tokens
80、Qwen3开源模型
Qwen3系列新一代代码生成模型,效果接近Qwen3-Coder-Plus兼具更优性能。模型重点优化仓库级别理解、支持多轮工具交互、提升对于agentic coding类工具的适配能力。
输入:¥1-2.5/M tokens
输出:¥4-10/M tokens
81、Qwen3-TTS-Instruct-Flash
Qwen3-TTS-Flash模型是通义实验室最新推出的实时语音合成大模型,Instruct模型可通过自然语言进行合成效果的处理,确保在不同语境下,合成情感、表达高度贴合的语音。目前支持25个音色的中英文Instruct调节。
¥0.8每万字符
82、Qwen3-TTS-VD
Qwen3-TTS-VD模型是通义最新推出的实时语音合成大模型,可对qwen3-voice-design服务设计的声音进行高保真实时语音合成,且同一音色支持11个语种的语音输出。该模型经过海量数据训练,合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。该模型为2026年01月26日快照版本模型。
¥0.8每万字符
83、Qwen3-TTS-VC
Qwen3-TTS-Flash模型是通义最新推出的实时语音合成大模型,可对qwen-voice-enrollment服务复刻的声音进行高保真实时语音合成,且同一音色支持11个语种的语音输出。该模型经过海量数据训练,合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。该模型为2026年01月22日快照版本模型。
¥0.8每万字符
84、Qwen-Rerank
基于 Qwen3.7底座训练的多语言通用文本重排序模型。相较 Qwen3-rerank,在通用与 Web 检索、代码检索、指令遵循、Agentic 与 Memory 检索等方面大幅提升;在 MTEB、websearch 等评测任务上均取得更优效果,其中 websearch 相对提升约 35%。
¥0.5/M tokens
85、Qwen3-VL-Plus
Qwen3系列视觉理解模型,实现思考模式和非思考模式的有效融合,视觉智能体能力在OS World等公开测试集上达到世界顶尖水平。此版本在视觉coding、空间感知、多模态思考等方向全面升级;视觉感知与识别能力大幅提升,支持超长视频理解。
输入:¥1-3/M tokens
输出:¥10-30/M tokens
86、Qwen3-VL-Flash
Qwen3系列小尺寸视觉理解模型,实现思考模式和非思考模式的有效融合,效果优于开源版Qwen3-VL-30B-A3B,响应速度快。全面升级图像/视频理解,支持长视频长文档等超长上下文、空间感知与万物识别;具备视觉2D/3D定位能力,胜任复杂现实任务。
输入:¥0.15-0.6/M tokens
输出:¥1.5-6/M tokens
87、Vidu AI生视频
ViduQ3-Drama 是面向精品剧/AI漫剧生产的专用模型,主打"一致性+动效+细节美学+性价比"四大维度的全面升级,效果更稳、情绪更真、动态更强。
¥0.875每秒
88、qwen3-tts-instruct-flash-realtime
千问3-TTS-Flash模型是通义实验室最新推出的实时语音合成大模型,Instruct模型可通过自然语言进行合成效果的处理,确保在不同语境下,合成情感、表达高度贴合的语音。目前支持25个音色的中英文Instruct调节。该模型等同于2026年01月22日快照版本模型。
¥1每万字符
89、Tripo
Tripo H3.1 是 Tripo 推出的高精度 3D 生成模型,专为需要极致视觉质量与细节表现的创作者设计。模型通过核心算法升级与模块优化,参数规模达 200 亿级,支持十亿体素级三维分辨率与最高 200 万面多边形生成。在保持高精度几何与真实纹理的同时,Tripo H3.1 对输入参考图的还原度与对齐度进一步提升,在角色形体、面部细节与几何文字等复杂结构上实现更稳定、细致的表达,适用于高质量视觉制作与 3D 打印等高精度资产生产场景。
¥0.7-4.2每次
90、Qwen3-TTS-VC-Realtime
千问3-TTS-Flash模型是通义最新推出的实时语音合成大模型,可对qwen-voice-enrollment服务复刻的声音进行高保真实时语音合成,且同一音色支持11个语种的语音输出。该模型经过海量数据训练,合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。该模型为2026年01月15日快照版本模型。
¥1每万字符180
91、Qwen3-TTS-VD-Realtime
千问3-TTS-VD模型是通义实验室最新推出的实时语音合成大模型,可对qwen3-voice-design服务设计的声音进行高保真实时语音合成,且同一音色支持11个语种的语音输出。该模型经过海量数据训练,合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。该模型为2026年01月15日快照版本模型。
¥1每万字符
92、音乐生成
fun-music-v1是百聆音乐生成大模型(Fun音乐大模型)支持输入开放性歌曲的创作要求或歌词,生成整首男/女声演唱的中文或英文歌曲。歌曲通俗易懂,情绪由浅入深,是人类灵感与大模型能力的完美结合。
¥0.002每秒180
93、MiniMax文本模型
MiniMax M3 凭借业界领先的 Coding 与 Agentic 能力、1M 超长上下文窗口以及原生多模态特性,可出色胜任企业级长文档理解、高质量内容生成、代码编写、Bug 修复及原生应用构建等任务;强大的 Agentic 能力端到端贯通工作流,原生多模态更带来流畅自然的图文混合交互体验。
输入:¥4.2/M tokens
输出:¥16.8/M tokens
94、MiniMax-Speech系列语音模型
MiniMax 语音大模型能够根据上下文,智能预测文本的情绪、语调等信息,并生成超自然、高保真、个性化的语音。在社交、播客、有声书、新闻资讯、教育、数字人等多种场景中展现出强大的实力。
¥3.5-9.9每次
95、Wan-T2I
万相2.6-文生图,画面质感、美学表现、指令遵循升级,在艺术风格精准控制、真实感人像、长文本生图及广泛历史文化IP覆盖上均表现出卓越能力,可生成高质量且富有表现力的视觉内容。
¥0.2每张
96、Qwen-声音设计
千问voice-design模型是千问语音模型的声音设计系列模型,仅需输入简单的文字描述,即可迅速设计出符合要求的相关声音。结合qwen3-tts-vd-realtime模型使用,可设计输出10个语种的语音。且合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。
¥0.2每次
97、Qwen3-LiveTranslate-Flash
Qwen3-LiveTranslate-Flash,一款高精度、高响应、高鲁棒性的多语言实时音视频同传大模型。依托Qwen3-Omni强大的基座能力、海量多模态数据、跨语言跨模态对齐和视觉增强等技术,Qwen3-LiveTranslate-Flash 实现了离线和实时两种音视频翻译能力,能听懂19种语言,会说10种语言以及8种中文方言。
输入:¥4/M tokens
输出:¥10/M tokens
98、Qwen3-Omni-Flash
千问3-Omni-Flash多模态大模型,基于Thinker–Talker混合专家(MoE)架构,支持文本、图像、音频、视频的高效理解与语音生成能力,可进行119种语言文本交互和20种语言语音交互,生成类人语音实现跨语言精准沟通。模型具备强大指令跟随与系统提示定制功能,灵活适配对话风格与角色设定,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态交互体验。
输入:¥1.8/M tokens
输出:¥6.9/M tokens
99、Qwen3-Omni-Flash-Realtime
千问3-Omni-Flash多模态大模型的实时版,基于Thinker–Talker混合专家(MoE)架构,支持文本、图像、音频、视频的高效理解与语音生成能力,可进行119种语言文本交互和20种语言语音交互,生成类人语音实现跨语言精准沟通。模型具备强大指令跟随与系统提示定制功能,灵活适配对话风格与角色设定,广泛应用于文本创作、语音助手、多媒体分析等场景,提供自然流畅的多模态交互体验。
输入:¥2.2/M tokens
输出:¥8.3/M tokens
100、Qwen3-TTS-Flash-Realtime
千问3-TTS-Flash-Realtime模型是通义实验室最新的实时语音合成大模型,不仅拥有17种高表现力的拟人音色,且能低延迟高稳定地实时合成音频;同时支持多种语言,方言,支持同一音色多语言输出。该模型经过海量数据训练,合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。
¥1每万字符
101、Qwen-声音复刻
千问voice-enrollment模型是千问语音模型的声音复刻系列模型,仅需5s以上的音频,即可迅速复刻高相似度声音。结合qwen3-tts-vc-realtime模型使用,可将一个人的声音高保真复刻,输出10个语种的语音。且合成音频可以根据文本自适应调节语气,对复杂文本合成也有较好的处理能力。
¥0.01次
102、Qwen3-LiveTranslate-Flash-Realtime
Qwen3-LiveTranslate-Flash的实时版本,一款高精度、高响应、高鲁棒性的多语言实时音视频同传大模型。依托Qwen3-Omni强大的基座能力、海量多模态数据、跨语言跨模态对齐和视觉增强等技术,通义千问3-LiveTranslate-Flash 实现了离线和实时两种音视频翻译能力,能听懂19种语言,会说10种语言以及8种中文方言。
输入:¥8/M tokens
输出:¥64/M tokens
103、Qwen3-Omni-30b-a3b-Captioner
千问3-Omni-30b-a3b-Captioner是一款强大的音频细粒度分析模型,专为在复杂多变的音频场景中生成精准、全面的内容描述而设计,可自动解析并描述从复杂语音、环境声到音乐、影视声效等各类音频内容,能够在多声源、混合化的环境中亦保持稳定而可信的输出。
输入:¥15.8/M tokens
输出:¥12.7/M tokens
104、Qwen-Flash
Qwen3系列Flash模型,实现思考模式和非思考模式的有效融合,可在对话中切换模式。复杂推理类任务性能优秀,指令遵循、文本理解等能力显著提高。支持1M上下文长度,按照上下文长度进行阶梯计费。
输入:¥0.15-1.2/M tokens
输出:¥1.5-12/M tokens
105、Qwen-Doc-Turbo
快速对文档进行精准信息抽取,打标分类,内容审核及摘要总结。
输入:¥0.6/M tokens
输出:¥1/M tokens
107、Qwen-TTS-Realtime
Qwen-TTS实时模型是通义实验室“qwen系列”模型中的语音合成模型。具备双向上下文感知能力,可以低延迟高保真完成多音色、方言及长文本的双向流式生成。
输入:¥2.4/M tokens
输出:¥12/M tokens
108、Qwen-TTS
千问系列首个语音合成模型,支持中文、英文、中英混合输入。自适应根据输入文本调整输出语气,音色真实自然,支持流式输出。
输入:¥1.6/M tokens
输出:¥10/M tokens
109、Qwen-Embedding
基于 Qwen3.7 训练的轻量级多语言文本向量模型,面向成本和吞吐敏感场景。相较 text-embedding-v4,在多语言覆盖(100→201 种)、长文本处理(32K→128K)和 Sparse Embedding 等能力上大幅升级;在语义、跨语言及代码检索评测上整体效果基本持平,其中 AIRBench-zh 提升约 3%
¥0.125/M tokens
110、Wan2.1-VACE-Plus
万相2.1-VACE-Plus,视频编辑统一模型。支持局部编辑、视频重绘、背景扩展、时长延展、图片参考等多种视频编辑与生成任务,支持文本、图像、视频等多模态条件控制。
¥0.7每秒120
111、Qwen2.5-开源模型
基于Qwen2.5训练的全新多模态理解生成大模型,支持文本, 图像,语音,视频输入理解和混合输入理解,具备文本和语音同时流式生成能力,多模态内容理解速度显著提升,提供了4种自然对话音色。
输入:¥0.6/M tokens
输出:¥2.4/M tokens
112、MiniMax
MiniMax-M2.5是MiniMax推出的旗舰级开源大模型,经过数十万个真实复杂环境中的大规模强化学习训练,M2.5 在编程、工具调用和搜索、办公等生产力场景都达到或者刷新了行业的 SOTA。
输入:¥2.1/M tokens
输出:¥8.4/M tokens
113、Qwen-VL-Max
千问VL-Max(qwen-vl-max),即千问超大规模视觉语言模型。相比增强版,再次提升视觉推理能力和指令遵循能力,提供更高的视觉感知和认知水平。在更多复杂任务上提供最佳的性能。
输入:¥1.6/M tokens
输出:¥4/M tokens
114、PixVerse V6
V6-r2v-omni是PixVerse在26年8月推出的新模型,是在现有 Video (T2V/I2V)、Transition (首尾帧)、Extend 基础上新增的能力,支持视频与图片混合输入生成视频
¥0.15-1.36每秒
115、可灵AI
kling/kling-v3-turbo-video-generation
生成更快,成本更低,音画同步精准,批量输出质量稳定可靠。
¥0.8-1
116、Qwen-VL-Plus
千问VL-Plus(qwen-vl-plus),即千问大规模视觉语言模型增强版。大幅提升细节识别能力和文字识别能力,支持超百万像素分辨率和任意长宽比规格的图像。在广泛的视觉任务上提供卓越的性能。
输入:¥0.8/M tokens
输出:¥2/M tokens
119、Qwen-Plus
Qwen3系列Plus模型,实现思考模式和非思考模式的有效融合,可在对话中切换模式。推理能力显著超过QwQ、通用能力显著超过Qwen2.5-Plus,达到同规模业界SOTA水平。
输入:¥0.8-4.8/M tokens
输出:¥2-48/M tokens
120、通义多模态向量
Embedding-Vision是基于LLM底座的视觉多模态表征模型,具有以视觉为中心、领域性能优异(电商、 安防、相册/图库、自驾等)、高性价比的特点。兼容文本、图像、视频3种模态,可应用于以图搜图、以文搜图、以文搜视频,以视频搜视频等下游任务场景。本模型(tongyi-embedding-vision-flash)是轻量化版本,在视觉向量化上具备极高性价比。
¥0.15/M tokens
121、人像风格重绘
人像风格重绘可以将输入的人物图像进行多种风格化的重绘生成,使新生成的图像在兼顾原始人物相貌的同时,带来不同风格的绘画效果。
¥0.12每张
122、虚拟模特
虚拟模特可以对上传的真人或者人台实拍商品展示图进行智能生成,将其中的模特和背景替换为心仪的内容,在保持人物姿态不变的情况下,使用虚拟模特对商品进行更加精美、多样的展示。支持各种与模特产生互动的商品,如手持小商品、服装、鞋靴、配饰等。
123、创意海报生成
创意海报生成,您的创意海报魔法工厂!它能够根据你的要求自动生成海报的背景和文字排版,支持多种海报风格,从宣传到祝福,让每一张海报都成为你的个性宣言。无需设计基础,轻松制作出彩作品,让创意触手可及。
124、万相-涂鸦作画
万相-涂鸦作画通过手绘任意内容加文字描述,即可生成精美的涂鸦绘画作品,作品中的内容在参考手绘线条的同时,兼顾创意性和趣味性。涂鸦作画支持扁平插画、油画、二次元、3D卡通和水彩5种风格,可用于创意娱乐、辅助设计、儿童教学等场景。
¥0.06每张
125、图像背景生成
图像背景生成可以基于输入的前景图像素材拓展生成背景信息,实现自然的光影融合效果,与细腻的写实画面生成。支持文本描述、图像引导等多种方式,同时支持对生成的图像智能添加文字内容。
¥0.08每张
126、万相-图像局部重绘
万相-图像局部重绘是基于自研的Composer组合生成框架的AI绘画创作大模型后置处理链路,能够根据用户输入的原始图片和意涂抹图中局部区域和prompt提示词文字内容,生成符合语义描述的多样化风格的局部重绘图像。通过知识重组与可变维度扩散模型,加速收敛并提升最终生成图片的效果, 布局自然、细节丰富、画面细腻、结果逼真。
127、PixVerse V5.6
上传任意图片,自由定制剧情、节奏与风格,生成生动连贯的视频。PixVerse V5.6 是爱诗科技自研的视频生成大模型,在文生视频与图生视频能力上实现全面升级。模型在画面清晰度、复杂运动稳定性与音画协同方面显著提升,多角色对话场景下嘴型与台词同步更准确,情绪表达更自然。同时优化构图、光影与质感一致性,整体生成质量进一步提升。PixVerse V5.6 在 Artificial Analysis 文生视频与图生视频榜单中位列全球第一梯队。
¥0.21-0.7每秒
128、GUI-Plus
GUI系列图形界面交互基础模型,针对手机端与电脑端图形界面理解与交互任务,性能优于开源版同类GUI模型。全面升级跨平台界面理解与多步任务规划,支持跨应用复杂任务;具备精细化动作执行与多角色多智能体协作能力,胜任真实复杂交互场景。
输入:¥1.5/M tokens
输出:¥4.5/M tokens
129、Qwen-Turbo
Qwen3系列Turbo模型,实现思考模式和非思考模式的有效融合,可在对话中切换模式。推理能力以更小参数规模比肩QwQ-32B、通用能力显著超过Qwen2.5-Turbo,达到同规模业界SOTA水平。
输入:¥0.3/M tokens
输出:¥0.6/M tokens
130、Qwen-QVQ-Plus
千问QVQ视觉推理模型增强版,支持视觉输入及思维链输出,在数学、编程、视觉分析、创作以及通用任务上都表现了更强的能力
输入:¥2/M tokens
输出:¥5/M tokens
131、Qwen-Omni-Turbo-Realtime
千问全新多模态理解生成大模型实时版,适合实时音频交互场景。支持音频伴随文本、图像、视频混合输入理解,具备语音和文本同时流式生成能力,提供了4种自然对话音色。
输入:¥1.6/M tokens
输出:¥6.4/M tokens
132、Qwen-QwQ-Plus
千问QwQ推理模型增强版,基于Qwen2.5模型训练的QwQ推理模型,通过强化学习大幅度提升了模型推理能力。模型数学代码等核心指标(AIME 24/25、livecodebench)以及部分通用指标(IFEval、LiveBench等)达到DeepSeek-R1 满血版水平。
输入:¥1.6/M tokens
输出:¥4/M tokens
133、Qwen-Long
Qwen-Long是在通义千问针对超长上下文处理场景的大语言模型,支持中文、英文等不同语言输入,支持最长1000万tokens(约1500万字或1.5万页文档)的超长上下文对话。配合同步上线的文档服务,可支持文本文件( TXT、DOCX、PDF、XLSX、EPUB、MOBI、MD、CSV)和图片文件(BMP、PNG、JPG/JPEG、GIF 以及PDF扫描件)的解析和对话。说明:通过HTTP直接提交请求,支持1M tokens长度,超过此长度建议通过文件方式提交。
输入:¥0.5/M tokens
输出:¥2/M tokens
134、Qwen-Plus-Character
千问系列角色扮演模型,本模型是动态更新版本,模型更新会提前通知,适合拟人化的角色扮演,同时优化了限定人设指令遵循、话题推进、倾听共情等能力,支持个性化角色的深度还原。
输入:¥0.8/M tokens
输出:¥2/M tokens
135、Qwen-Omni-Turbo
千问全新多模态理解生成大模型,支持文本, 图像,语音,视频输入理解和混合输入理解,具备文本和语音同时流式生成能力,多模态内容理解速度显著提升,提供了4种自然对话音色。
输入:¥0.4/M tokens
输出:¥1.6/M tokens
136、Qwen-Coder-Plus
千问系列代码及编程模型是专门用于编程和代码生成的语言模型,性能出色,效果突出。
输入:¥3.5/M tokens
输出:¥7/M tokens
137、Qwen-Math-Turbo
千问系列数学模型是专门用于数学解题的语言模型,推理速度快,成本低。
输入:¥2/M tokens
输出:¥6/M tokens
138、Qwen-Math-Plus
千问数学模型具有强大的数学解题能力,擅长处理中英文数学题,包括方程、计算、证明等方向。
输入:¥4/M tokens
输出:¥12/M tokens
139、Qwen-Max
千问2.5系列千亿级别超大规模语言模型,支持中文、英文等不同语言输入。随着模型的升级,qwen-max将滚动更新升级。如果希望使用固定版本,请使用历史快照版本。
输入:¥2.4/M tokens
输出:¥9.6/M tokens
140、Qwen-Coder-Turbo
千问系列代码及编程模型是专门用于编程和代码生成的语言模型,推理速度快,成本低。
输入:¥2/M tokens
输出:¥6/M tokens
141、伶鹊-对话分析-flash
伶鹊-对话分析-flash是专注于日常任务,如对话信息抽取、场景分类等分析类需求的模型,自定义分析标准遵循与对话语义理解能力显著提升,适用于低时延的离线在线分析任务。
输入:¥0.2/M tokens
输出:¥0.4/M tokens
142、伶鹊-对话分析-pro
伶鹊-对话分析-pro是专注于高阶复杂分析,如针对具备复杂业务逻辑的复杂质检规则等分析需求的模型,支持自定义更细粒度的分析标准,具备更强的多轮上下文建模、深层语义理解与推理能力。
输入:¥1/M tokens
输出:¥2.7/M tokens
143、Z-Image-Turbo
Z-Image-Turbo是在Artificial Analysis评测中荣登文生图开源模型世界第一的高效图像生成模型,仅用60亿参数和8步推理就能生成媲美大规模商业模型的照片级真实感图像,并在中英双语文本渲染、复杂语义理解和多样化主题生成上表现卓越。
¥0.1每张
144、AI试衣-Plus版
aitryon-plus是一款效果出众的虚拟试衣图片生成模型,可基于服饰平拍图片以及人物正面全身照,输出服饰的人物试衣效果图片。 相较于aitryon模型,aitryon-plus模型在图片清晰度、服饰纹理细节和logo还原效果等方面均有提升,但生成耗时较长,适用于对时效性要求不高的场景。
¥0.5每张
145、Sambert语音合成
提供SAMBERT+NSFGAN深度神经网络算法与传统领域知识深度结合的文字转语音服务,兼具读音准确,韵律自然,声音还原度高,表现力强的特点。
¥1每万字符
146、Paraformer实时语音识别-8k-v2
推荐使用 Paraformer最新实时语音识别模型,支持多个语种自由切换的视频直播、会议等实时场景的语音识别。可以通过language_hints参数选择语种获得更准确的识别效果。支持8kHz电话客服等场景下的实时语音识别。 支持的语言包括:中文(含粤语等各种方言)、英文、日语、韩语。
¥0.00024每秒
147、Paraformer实时语音识别-8k-v1
Paraformer中文实时语音识别模型,支持8kHz电话客服等场景下的实时语音识别。
¥0.00024每秒
148、Paraformer语音识别-8k-v2
Paraformer最新中文语音识别模型,模型结构升级,具有更好的识别效果,支持8kHz电话语音识别,仅支持中文热词。
¥0.00008每秒
149、Paraformer实时语音识别-v1
Paraformer中文实时语音识别模型,支持16kHz及以上采样率的视频直播、会议等实时场景下的语音识别。
¥0.00024
150、Paraformer语音识别-8k-v1
Paraformer语音识别提供的文件转写API,能够对常见的音频或音视频文件进行语音识别,并将结果返回给调用者。Paraformer中文语音识别模型,支持8kHz电话语音识别。
¥0.00008每秒
151、Paraformer实时语音识别-v2
推荐使用 Paraformer最新实时语音识别模型,支持多个语种自由切换的视频直播、会议等实时场景的语音识别。可以通过language_hints参数选择语种获得更准确的识别效果。支持任意采样率。 支持的语言包括:中文(含粤语等各种方言)、英文、日语、韩语。 可支持热词。
¥0.00024每秒
152、Paraformer语音识别-v2
推荐使用 Paraformer最新语音识别模型,支持多个语种的语音识别。可以通过language_hints参数选择语种获得更准确的识别效果,支持任意采样率。 支持的语言包括:中文(含粤语等各种方言)、英文、日语、韩语。可支持热词。
¥0.00008每秒
153、Paraformer语音识别-v1
Paraformer中英文语音识别模型,支持16kHz及以上采样率的音频或视频语音识别。
¥0.00008每秒
154、通义法睿-Plus-32K
通义法睿是以通义千问为基座经法律行业数据和知识专门训练的法律行业大模型产品,综合运用了模型精调、强化学习、 RAG检索增强、法律Agent技术,具有回答法律问题、推理法律适用、推荐裁判类案、辅助案情分析、生成法律文书、检索法律知识、审查合同条款等功能
输入:¥20/M tokens
输出:¥20/M tokens
155、Paraformer语音识别-mtl-v1
Paraformer多语言语音识别模型,支持16kHz及以上采样率的音频或视频语音识别。 支持的语种/方言包括:中文普通话、中文方言(粤语、吴语、闽南语、东北话、甘肃话、贵州话、河南话、湖北话、湖南话、宁夏话、山西话、陕西话、山东话、四川话、天津话)、英语、日语、韩语、西班牙语、印尼语、法语、德语、意大利语、马来语。
¥0.00008每秒
156、WordArt锦书-文字变形
WordArt锦书-文字变形可以对输入的文字边缘轮廓进行创意变形,根据提示词内容进行边缘变化,实现一种字体的更多种创意用法,返回带有文字内容的黑底白色mask图。
¥0.24每张
157、WordArt锦书-文字纹理生成
WordArt锦书-文字纹理生成可以对输入的文字内容或文字图片进行创意设计,根据提示词内容对文字添加材质和纹理,实现立体凸显或场景融合的效果,生成效果精美、风格多样的艺术字,结合背景可以直接作为文字海报使用。
¥0.08每张
158、FaceChain人物写真生成
基于人物形象训练已经得到的形象,可以继续通过人物生成写真模型完成该形象的写真生成,支持多种预设风格,包括证件照、商务写真等。
¥0.18每张
159、FaceChain人物图像检测
对用户上传的人物图像进行检测,判断其中所包含的人脸是否符合facechain微调所需的标准,检测维度包括人脸数量、大小、角度、光照、清晰度等多维度,支持图像组输入,并返回每张图像对应的检测结果。
160、实时语音识别及翻译V1.0
多语言语音转写及翻译的多模态大模型。本模型提供长时间、高准确率、实时转写中/英/日/韩等10个混合语种的服务。同时支持中英日韩互译,以其他6个语种翻译成中文或英文。
¥0.00015每秒
161、一句话识别及翻译V1.0
多语言语音转写及翻译的多模态大模型。本模型支持60秒以内的实时语音识别,适用于语音搜索、设备指令等场景。提供10个混合语种的高准确率识别服务,同时支持中英日韩互译,以其他6个语种翻译成中文或英文。
¥0.00015每秒
162、表情包Emoji
表情包emoji是一款人脸动效视频生成模型,可基于人脸图片和预设的人脸动态模板,生成人脸动效视频。
¥0.08每秒
163、表情包Emoji-detect
表情包Emoji-Detect是辅助表情包Emoji生成的图像检测模型,用于检测图片中的人物形象是否符合视频生成要求。
¥0.004每张
164、AI试衣OutfitAnyone-图片分割
图片分割模型是AI试衣OutfitAnyone的辅助模型,可对模特图、服饰图进行分割,用于试衣图片的前后处理。
¥0.004每张
165、舞动人像AnimateAnyone
AnimateAnyone是一款视频生成模型,可基于人物图片和动作模板生成人物全身动作视频。
¥0.08每秒
166、意图分类模型
意图识别和槽位填充是对话系统中的基础任务。本模型实现了一个基于 API的意图(intent)和槽位参数(slots)联合预测。在一次模型输出中,同时完成多个指令API的返回和槽位参数的填充。返回的结果为标准json格式。
输入:¥0.4/M tokens
输出:¥1/M tokens
167、灵动人像LivePortrait
LivePortrait是一款视频生成模型,可基于人物图片生成轻量化的人物肖像动态视频。
¥0.02每秒
168、灵动人像LivePortrait-detect
LivePortrait-detect是辅助LivePortrait的图像检测模型,用于检测图片中的人物形象是否符合视频生成要求。
¥0.004每张
169、舞动人像AnimateAnyone-template
AnimateAnyone-Template是辅助AnimateAnyone的动作模板生成模型,可基于视频提取人物动作并制作模板。
¥0.08每秒
170、舞动人像AnimateAnyone-detect
AnimateAnyone-detect是辅助AnimateAnyone的图像检测模型,用于检测图片中的人物形象是否符合视频生成要求。
¥0.004每张
171、声动人像VideoRetalk
VideoRetalk是一个人物视频生成模型,可基于人物视频和人声音频,生成人物讲话口型与输入音频相匹配的新视频。
¥0.08每秒
172、悦动人像EMO
EMO是一款视频生成模型,可基于人物图片生成高质量的人物肖像动态视频。
¥0.08-0.16每秒
173、悦动人像EMO-detect
EMO-Detect是辅助EMO的图像检测模型,用于检测图片中的人物形象是否符合视频生成要求。
¥0.004每张
174、图像擦除补全
图像擦除补全通过指定图像mask中要删除的人体、宠物、物品、文字、水印等图像区域,在保留背景的同时移除图像中的一个或多个人物、物体、文字等元素,此功能不支持输入prompt的消除。擦除补全技术结合了计算机视觉、AIGC inpainting等先进技术,可以在多种场景下应用,从而满足用户对隐私保护、内容创作和图像编辑等方面需求。
175、人物实例分割
人物实例分割运用了检测和分割技术,不仅能够在图像中识别出不同的对象,而且还能准确地画出每一个对象边界的像素级掩码(mask)。
176、AI试衣OutfitAnyone-图片精修
图片精修是对AI试衣生成的效果图进行二次生成,输出还原度更高的精修试衣效果图。
¥0.15-0.3每张
177、虚拟模特V2
虚拟模特可以对上传的真人或者人台实拍商品展示图进行智能生成,将其中的模特和背景替换为心仪的内容,在保持人物姿态不变的情况下,使用虚拟模特对商品进行更加精美、多样的展示。支持各种与模特产生互动的商品,如手持小商品、服装、鞋靴、配饰等。
178、鞋靴模特
鞋靴模特支持输入多视角鞋靴系列图片,同时对输入模特模板图的鞋子区域进行鞋靴AI试穿,实现模特鞋靴布局重绘生成,最终生成图片的效果, 布局自然、细节丰富、画面细腻、试穿结果逼真。可用于模特商品图设计、新鞋AI试穿、模特穿戴布局重绘等场景。
179、AI试衣-基础版
aitryon是一款性能出众的虚拟试衣图片生成模型,可基于服饰平拍图片以及人物正面全身照,输出服饰的人物试衣效果图片。aitryon模型可在较短时间内生成试衣图片,适用于对时效性要求较高的场景。
¥0.2每张
180、图像画面扩展
图像画面大模型,对输入图像进行画面自由扩展,支持旋转画面,支持按照扩展系数和扩展像素数两种方式进行扩图。用户可以通过指定宽度、高度画面扩展比例或者左、右、上、下的扩展的像素值来控制画面扩展,可用于创意娱乐、辅助作图、画面设计、影视后期制作等场景。
181、视频风格重绘
视频风格重绘可以将输入的视频帧序列进行多种风格化的重绘/生成,使新视频画面在兼顾原始人物和物体相貌的同时,带来不同风格的绘画效果。当前支持预置重绘风格包括日式漫画、美式漫画、清新漫画、3D卡通、国风卡通。
¥0.2-0.5每秒
182、语音识别热词
热词是指用户可以预先定义的一组特定词汇或短语,这些词汇或短语在识别、翻译过程中会被赋予更高的优先级。针对您的特定业务领域,如果有部分词汇的语音识别、翻译效果不够好,可以将这些关键词或短语添加为热词进行优先识别或翻译,从而提升识别、翻译效果。
183、QVQ-Max
千问QVQ视觉推理模型,支持视觉输入及思维链输出,在数学、编程、视觉分析、创作以及通用任务上都表现了更强的能力。
输入:¥8/M tokens
输出:¥32/M tokens
184、PixVerse Capabilities
Motion Control 支持从参考视频中提取动作,并迁移到目标人物图片上,生成角色复现相同动作的新视频。
¥0.27-0.36每秒
185、PixVerse C1
C1是PixVerse在26年3月底推出的影视行业大模型,r2v(多主体参考生成视频)输入2-7张图像,智能融合不同主体,同时拥有t2v(文字生成视频)的提示词控制能力,和it2v(图片生成视频)的一致性保持能力和想象力、更接近影视专业水准的打斗动作和术法特效。支持15秒长视频、音乐和视频直出、支持多种语言文字。适合多主体群像、多人对话、多人交互等复杂剧情,适合中景、全景镜头。 如果输入了1张多宫格分镜图片(最高支持九宫格),则可以一键生成连续分镜长视频。
¥0.18-0.71每秒
186、StepFun推理模型
Step 3.7 Flash 是阶跃星辰最新推出的生产级 Agent 高效率 Flash 模型,专为 Agent、Coding、Search 与多模态工作流打造,在速度、成本、执行可靠性与复杂任务完成能力之间实现了更优平衡。具备多模态感知与执行、视觉搜索与工具增强、高可靠工具调用与编排,以及 Agent 生态兼容优化等核心能力。
输入:¥1.35/M tokens
输出:¥8.1/M tokens
187、Vidu AI生图
输入0-14张参考图片或文本描述,支持参考生图、文生图、图片编辑,对中英文字的精准渲染、UI/图表等设计细节的像素级还原,适合制作海报、信息图等。
¥0.3125-0.40625每张
188、Qwen3-TTS-Flash
韵律拟人,低延迟,支持十种语言和国内多种方言输出
¥0.8每万字符
189、HappyHorse-1.0
HappyHorse-1.0-R2V支持参考生视频,更加稳定的主体与场景参考,支持最多9张图片参考,能够精准保持创作意图,实现更强表现能力。
¥0.9-1.6每秒
190、HappyHorse-1.1
HappyHorse-1.1-T2V支持文生视频,进一步提升文本语义理解、镜头调度与动态生成表现。模型能够更精准地还原创作意图,在人物动作、场景氛围、视觉美感和物理运动上生成更流畅自然、细节丰富且一致性更高的高质量视频。
¥0.45-1.2每秒
191、云知声文本模型
Unisound U2 是云知声最新推出的原生 Agent 旗舰模型,在代码开发、复杂推理、深度研究及一系列通用智能任务上具备出色表现。同时,Unisound U2 也是云知声面向 Agent 场景打造的高效智能模型,支持长文本理解、任务拆解、工具调用与多步骤执行,可广泛应用于智能体、软件工程、企业分析及自动化工作流等场景。
输入:¥1/M tokens
输出:¥2/M tokens
三、模型选型建议
面对191款大模型的丰富选择,如何根据自身需求选择最合适的模型是许多开发者和企业面临的实际问题。以下提供一些选型建议:
按性能需求选择
- 追求极致性能: 选择Qwen3.8-Max或Qwen3.8-2.4T-A95B,适合对输出质量要求极高的专业场景。
- 平衡性能与成本: 选择Qwen3.8-Flash或GLM-5.3-Flash,在保持较高性能的同时大幅降低使用成本。
- 轻量级应用: 可以选择参数量更小的模型,适合对响应速度要求高、并发量大的场景。
按应用场景选择
- 文本生成与对话: 千问系列文本模型、GLM系列、DeepSeek系列
- 图像理解与生成: 千问视觉模型、万相系列
- 视频创作: Wan3.0-Video系列
- 代码开发: Qwen3.8-Flash、DeepSeek系列
- 办公自动化: GLM-5.3-Flash、Qwen3.8-Max
按预算选择
阿里云百炼平台提供了从免费额度到按量付费的多种计费方式,用户可以根据自身预算灵活选择。对于初创团队和个人开发者,建议从轻量级模型开始,逐步根据业务增长升级模型规格。
四、平台接入指南
阿里云百炼平台提供了简洁高效的API接入方式,开发者只需完成以下步骤即可开始使用:
- 注册阿里云账号: 访问阿里云官网完成账号注册和实名认证。
- 开通百炼服务: 在阿里云控制台中找到百炼平台,开通相关服务。
- 获取API Key: 在百炼平台控制台创建API密钥,用于后续接口调用。
- 选择模型: 根据业务需求从191款模型中选择合适的模型。
- 集成开发: 使用SDK或直接调用REST API完成应用集成。
平台还提供了完善的文档、示例代码和技术支持,帮助开发者快速上手。
五、阿里云大模型相关活动参考
为了帮助更多开发者和企业用户更好地使用千问大模型,阿里云持续推出各类优惠活动和资源支持计划。
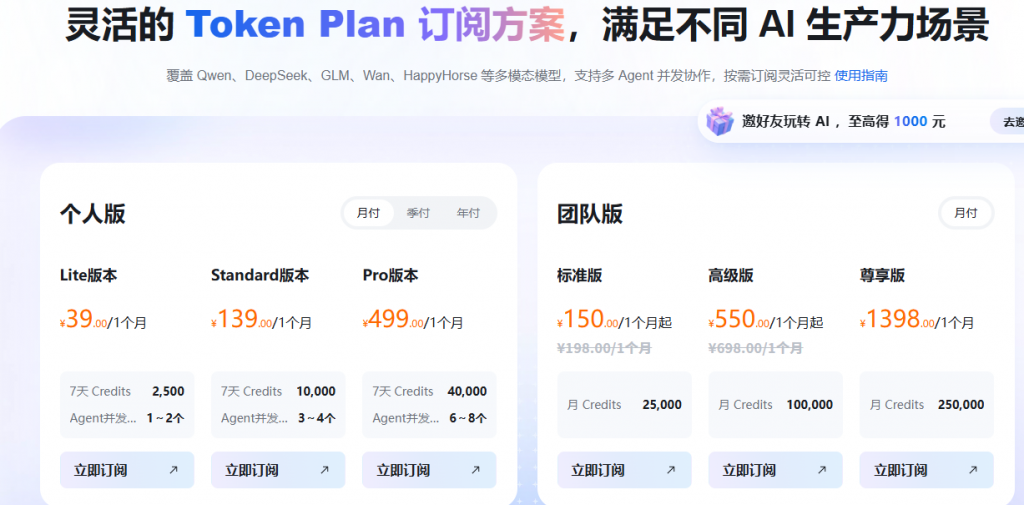
Token Plan活动是目前阿里云大模型服务中备受关注的优惠活动之一。Token Plan允许用户以预付费的方式购买一定数量的Token额度,享受比按量付费更优惠的价格。不同规格的Token Plan对应不同的折扣力度,用户可以根据自身的实际用量需求选择合适的套餐。对于用量较大的企业用户来说,Token Plan能够显著降低AI调用的成本。详情可访问阿里云百炼Token Plan服务页面:https://www.aliyun.com/benefit/scene/tokenplan
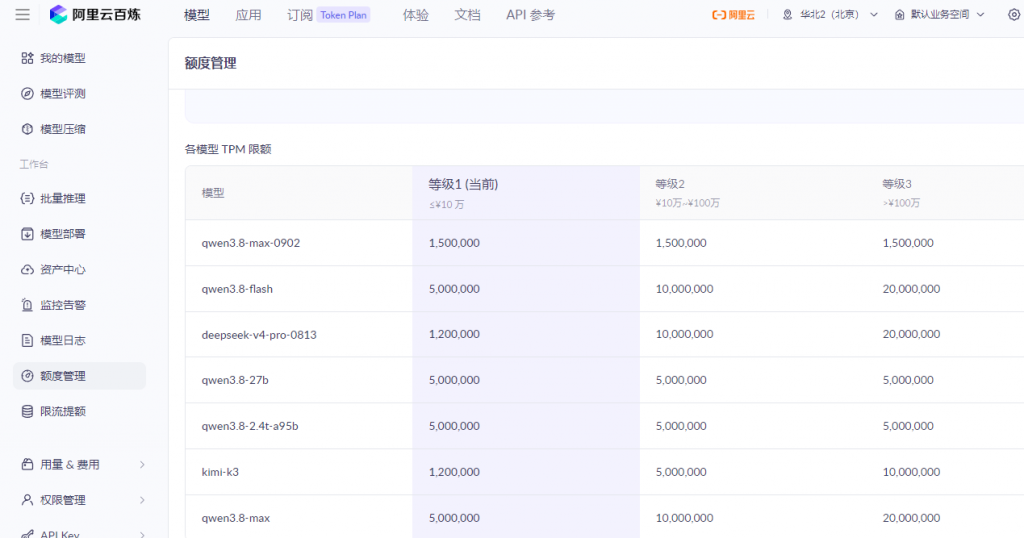
新用户免费体验活动。 首次开通阿里云百炼的用户,系统自动为每个模型发放100万Token免费额度(输入与输出共用总额度),覆盖70+主流模型,总额度超7000万Token。自开通百炼之日起90天内有效,过期后自动失效,不支持补发、延期或重置。仅支持华北2(北京)地域的模型实时推理调用,不支持Batch批量调用、模型调优等场景。新人免费额度介绍:https://help.aliyun.com/zh/model-studio/new-free-quota
模型限时免费活动。 阿里云会不定期推出特定模型的限时免费调用活动,让用户能够免费体验最新发布的模型能力。这类活动通常在新模型发布初期推出,是用户第一时间体验新技术的好机会。详情可通过百炼平台了解:https://www.aliyun.com/product/bailian

企业专属优惠。 针对企业级用户,阿里云提供了专属的商务咨询和定制化方案。企业用户可以根据自身业务需求,获得更灵活的计费方式、更高的调用配额以及更专业的技术支持服务。
Night Plan夜间错峰优惠
每晚22:00至次日08:00(北京时间),Qoder和秒悟Meoo客户可享受大幅折扣。根据2026年8月的定价信息,qwen3.8-max夜间时段计费系数可降至0.01倍(即按原价1%计费);根据2026年7-8月的活动信息,qwen3.7-max可享2折优惠;qwen3.7-plus、qwen3.7-flash等模型的夜间错峰折扣权益,具体折扣力度建议以百炼控制台实时展示为准。覆盖产品包括Qoder全系及秒悟Meoo网页端,Pro Trial试用用户及付费订阅用户自动生效。活动详情可参考:https://www.aliyun.com/benefit/client/nightplan

六、总结
阿里云百炼平台凭借191款大模型的丰富生态,为开发者和企业提供了前所未有的AI能力选择空间。从旗舰级的Qwen3.8-Max到轻量高效的Qwen3.8-Flash,从文本生成到视频创作,从开源模型到商业服务,平台覆盖了AI应用的方方面面。
随着大模型技术的持续发展和应用场景的不断拓展,阿里云百炼平台将继续扩充模型生态,提升服务质量,为更多用户带来AI赋能的价值。无论是个人开发者的创意实验,还是企业级的规模化应用,都能在这里找到最适合的AI解决方案。
👉友情提示:购买之前,别忘了先领阿里云免费赠送的折扣优惠券:
https://www.aliyun.com/minisite/goods 领了之后再买活动中的所有云产品,均可享受活动价格额外折扣,最高可减12500元。
本文信息基于阿里云百炼平台公开资料整理,具体模型能力和定价以平台最新公告为准。如需了解更多详情,请访问阿里云百炼平台:https://www.aliyun.com/product/tongyi