Qwen3.8-Flash 是通义千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。同时兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 是开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
一、阿里云Qwen3.8-Flash模型概述
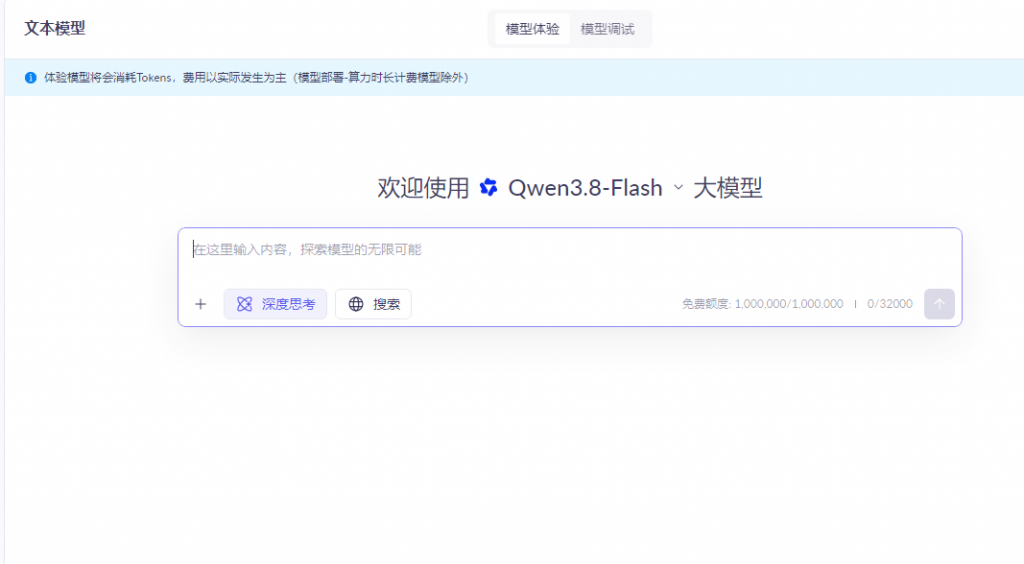
Qwen3.8-Flash 是千问系列最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度,是面向开发者与企业级应用场景打造的”效果与效率兼得”的理想选择。该模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话,彻底打破了传统模型在处理长文本时的容量瓶颈。
在实际应用场景中,Qwen3.8-Flash 的表现尤为全面:在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。与此同时,该模型兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,帮助开发者轻松构建高并发应用与智能工作流,大幅降低迁移与集成成本。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 已成为开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
从模态支持能力来看,Qwen3.8-Flash 支持文本与代码输入输出,同时支持非实时图像理解与非实时视频理解,输入侧涵盖图像、文本、视频等多种模态,输出侧以文本为主,充分体现了其多模态大模型的定位。
二、阿里云Qwen3.8-Flash模型能力
Qwen3.8-Flash 在功能层面提供了丰富而完善的特性支持,具体包括以下几项:
- 前缀补全:支持前缀补全能力,可根据给定前缀续写内容,适用于代码补全、文本续写等场景。
- 缓存:支持上下文缓存机制,命中缓存的输入 token 可享受大幅价格优惠,显著降低重复调用成本。
- 批量任务:支持 Batch 批量处理模式,通过 Batch File 与 Batch Chat 两种方式提供折扣价格,适合离线大批量推理任务。
- 函数调用:支持 Function Calling,模型可自主调用外部函数与工具,是构建智能体(Agent)应用的核心能力。
- 结构化输出:支持 JSON 等结构化格式输出,便于程序化解析与下游系统集成。
- 联网搜索:支持联网搜索能力,模型可获取实时信息,提升回答的时效性与准确性。
需要说明的是,微调功能当前暂未开放支持。总体而言,Qwen3.8-Flash 的功能矩阵覆盖了从基础推理到智能体构建的完整链路,能够满足绝大多数生产级应用的需求。
各地域能力支持对比
Qwen3.8-Flash 已在华北2(北京)、新加坡、德国(法兰克福)、日本(东京)、美国(弗吉尼亚)、中国香港等多个地域部署上线,各地域的能力支持情况如下:
华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
美国(弗吉尼亚)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
中国香港
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text Video | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 不支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
三、阿里云Qwen3.8-Flash上下文限制
在速率限制与上下文容量方面,Qwen3.8-Flash 提供了业界领先的参数配置:
- 最大输入:991K tokens;
- 最大输入(思考模式):983K tokens;
- 上下文:1M tokens(百万级上下文窗口);
- TPM(每分钟 token 数):5M;
- 最大输出:131K tokens;
- 最大输出(思考模式):131K tokens;
- 最大思维链:262K tokens。
百万级上下文意味着模型可以一次性载入整部法律卷宗、整套代码仓库或数小时的会议记录进行分析;高达 5M 的 TPM 限额则为高并发服务提供了充足吞吐保障;而 262K 的思维链长度上限,确保了模型在深度思考模式下仍能进行充分、细致的推理,兼顾了”快”与”深”的双重需求。
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991808 | 最大输出长度 | 131072 |
| 最大输入长度(思考模式下) | 983616 | 最大输出长度(思考模式下) | 131072 |
| 上下文长度 | 1000000 | 最大思维链长度 | 262144 |
四、阿里云Qwen3.8-Flash模型价格
Qwen3.8-Flash 的定价分为”模型”与”内置工具”两部分,价格极具竞争力。
模型调用定价:
- 输入:¥0.8 / M tokens;
- 输入(缓存命中):¥0.1 / M tokens,仅为标准输入价格的约八分之一;
- 输出:¥2.7 / M tokens;
- 输入(Batch File):¥0.4 / M tokens,批量文件模式享受半价优惠;
- 输出(Batch File):¥1.35 / M tokens,同样为标准输出价格的五折;
- 显式缓存创建:¥1.25 / M tokens;
- 显式缓存命中:¥0.1 / M tokens;
- 输入(Batch Chat):限时5折,由 ¥0.8 降至 ¥0.4 / M tokens;
- 输出(Batch Chat):限时5折,由 ¥2.7 降至 ¥1.35 / M tokens。
内置工具定价:
- 代码解释器(code_interpreter):免费;
- 网页抓取(web_extractor):免费;
- web_fetch:免费;
- 以文搜图(t2i_search):¥24 / K 调用;
- 以图搜图(i2i_search):¥48 / K 调用;
- 联网搜索(web_search):¥4 / K 调用;
- PDF 理解(pdf_parsing):¥0.02 / 页;
- web_search:¥4 / K 调用。
可以看出,Qwen3.8-Flash 在保证模型能力的同时,通过缓存命中折扣、Batch 批量折扣和限时五折活动等多重优惠机制,将推理成本压缩到极低水平,尤其适合高并发、长上下文、大批量的生产级应用。
下文仅展示模型调用原价,不包含限时优惠等活动信息,详情可通过百炼平台了解:https://www.aliyun.com/product/bailian

各地域定价详情
华北2(北京)
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
新加坡
部署范围:国际
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1.094 | 每百万tokens |
| 输出 | 3.427 | 每百万tokens |
| 输入(缓存命中) | 0.117 | 每百万tokens |
| 显式缓存创建 | 1.458 | 每百万tokens |
| 显式缓存命中 | 0.117 | 每百万tokens |
德国(法兰克福)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
日本(东京)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
美国(弗吉尼亚)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 0.8 | 每百万tokens |
| 输出 | 2.7 | 每百万tokens |
| 输入(缓存命中) | 0.1 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
五、阿里云Qwen3.8-Flash模型内置工具
Qwen3.8-Flash 内置了八大工具,覆盖代码执行、多模态检索、网页信息获取与文档解析等能力:
- 代码解释器(code_interpreter):基于 Responses API,支持在对话中执行代码,免费使用;
- 以图搜图(i2i_search):基于 Responses API,支持以图像检索相似图像,¥48 / K 调用;
- 以文搜图(t2i_search):基于 Responses API,支持以文本检索图像,¥24 / K 调用;
- 网页抓取(web_extractor):基于 Responses API,支持抓取并解析网页内容,免费使用;
- 联网搜索(web_search):基于 Responses API,支持实时联网检索,¥4 / K 调用;
- PDF 理解(pdf_parsing):基于 Completions API,支持 PDF 文档解析理解,¥0.02 / 页;
- web_fetch:基于 Anthropic API,支持网页内容获取,免费使用;
- web_search:基于 Anthropic API,支持网络搜索,¥4 / K 调用。
这些内置工具使 Qwen3.8-Flash 不再只是一个”对话模型”,而是一个能够执行代码、检索图文、抓取网页、解析文档的完整智能体底座。
六、阿里云Qwen3.8-Flash限流
华北2(北京)
本地域采用动态限流机制,TPM 限流值按百炼平台月消费额度分档,RPM 限额较高、正常使用不会触发限流。
新加坡
部署范围:国际
本地域采用动态限流机制,TPM 限流值按百炼平台月消费额度分档,RPM 限额较高、正常使用不会触发限流。
德国(法兰克福)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 30,000 |
| TPM(每分钟tokens) | 5,000,000 |
日本(东京)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 30,000 |
| TPM(每分钟tokens) | 5,000,000 |
美国(弗吉尼亚)
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 30,000 |
| TPM(每分钟tokens) | 5,000,000 |
中国香港
部署范围:全球
| 参数 | 值 |
|---|---|
| RPM(每分钟请求数) | 30,000 |
| TPM(每分钟tokens) | 5,000,000 |
七、阿里云Qwen3.8-Flash模型API参考
Qwen3.8-Flash 提供 OpenAI 与 DashScope 两种接口规范,并支持 Python、Node.js、cURL 三种调用方式,同时兼容 Completions API 与 Responses API。以下以 Python + OpenAI 兼容接口(Completions API)为例,展示流式调用并分离”思考过程”与”完整回复”的典型代码:
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.8-flash",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
该示例通过 enable_thinking 参数开启思考模式,并在流式输出中自动区分 reasoning_content(思考过程)与 content(完整回复),便于开发者在应用中分别展示推理链与最终答案。结合其对 OpenAI 与 Anthropic 协议的双重兼容,现有应用几乎无需改造即可平滑迁移至 Qwen3.8-Flash,快速享受百万级上下文与极致性价比带来的全新体验。
八、价格与优惠
截至目前,qwen3.8-flash正在进行多项限时优惠活动:
1、Night Plan夜间错峰优惠:每日22:00至次日08:00,Token Plan用户调用qwen3.8-flash的Credits消耗享折扣,搭配上下文缓存可进一步降低使用成本,适合批量代码分析、长文档处理、多轮Agent调试等高消耗场景,权益自动生效无需手动操作;活动详情可参考:https://www.aliyun.com/benefit/client/nightplan

2、AI焕新季满减券:2026年9月30日前,完成实名认证并开通百炼平台的特邀用户,可领取满20减10、满99减15、满199减35三档满减券,可用于Token Plan订阅、Qoder套餐等产品抵扣,领取后14天内有效;详情可参考:https://www.aliyun.com/benefit

3、OPC创新助力计划:面向独立开发者、自由职业者及”一人公司”,提供最低1000元、最高100万元Token补贴,采用”先用后返”模式,根据实际消费金额次月获得相应额度的满返优惠券,加速AI创新落地;详情可参考:https://opc.aliyun.com/products

4、Token Plan限时活动价:个人版三档套餐均有限时优惠,团队版标准坐席限时150元/席位/月,相比按量付费可节省30%以上成本,适合高频使用的开发者和团队。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan

👉友情提示:购买之前,别忘了先领阿里云免费赠送的折扣优惠券:
https://www.aliyun.com/minisite/goods 领了之后再买活动中的所有云产品,均可享受活动价格额外折扣,最高可减12500元。
总结:Qwen3.8-Flash 凭借百万级上下文窗口、多模态理解能力、双协议兼容以及极具竞争力的定价(输入低至0.8元/M tokens、缓存命中仅0.1元/M tokens),已成为开发者和企业在 AI 应用中兼顾效果与效率的理想选择。结合 Night Plan 夜间五折、AI焕新季满减券、OPC创新助力计划、Token Plan限时活动价等多重优惠,当前正是入手体验的最佳时机。建议开发者先通过免费额度充分体验模型能力,再结合自身场景选择合适的付费方案,把每一分预算都花在刀刃上。